
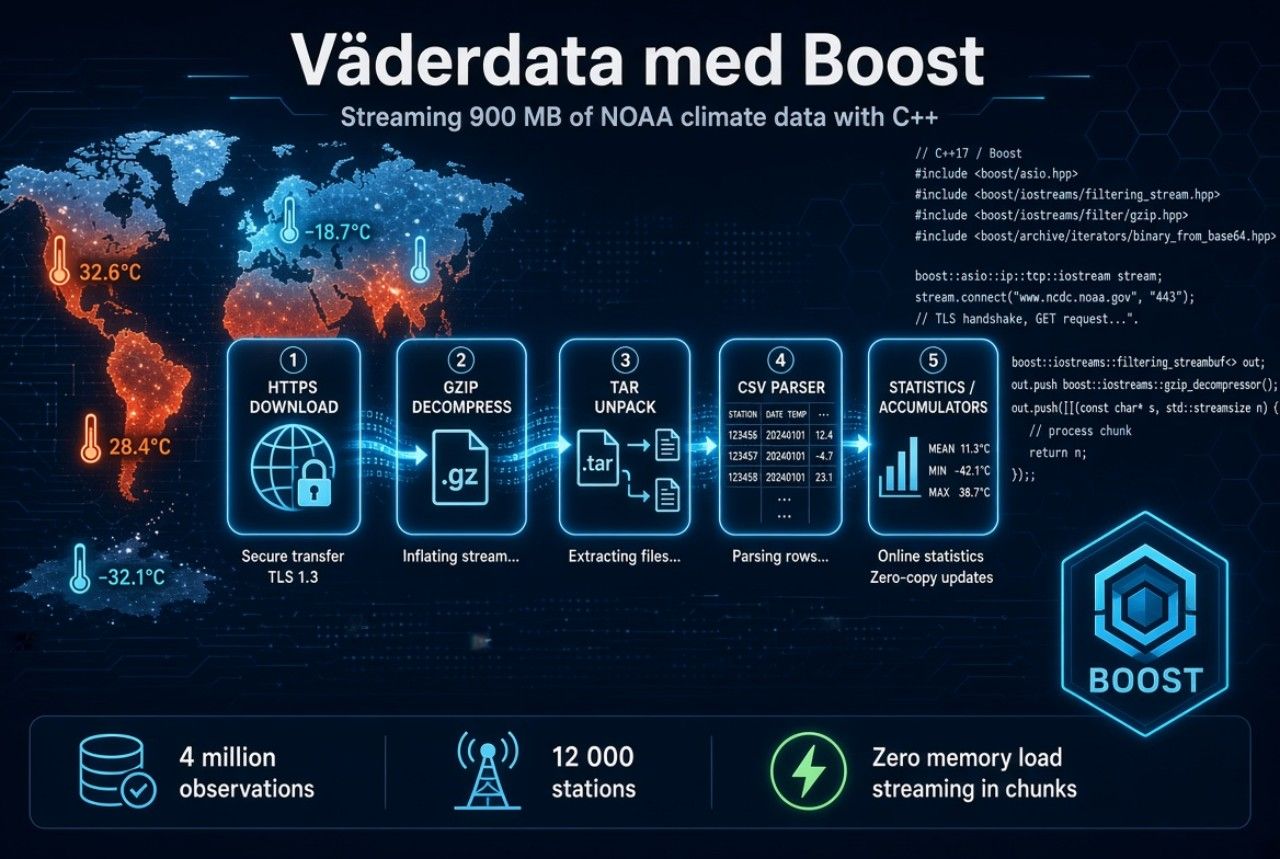
Varje dag sedan 1929 har väderstationer runt om i världen noterat temperatur, nederbörd och vind. Den amerikanska myndigheten NOAA delar generöst med sig av allt detta: ett arkiv per år, med en fil för var och en av drygt tolv tusen stationer. För 2024 blir det nästan 900 MB data och fyra miljoner observationer. Frågan är enkel: vilka stationer hade årets varmaste respektive kallaste medeltemperatur? Att svara på den är lite svårare, i alla fall om man inte vill ladda ned, packa upp och läsa in allt i minnet först.
I min förra artikel beskrev jag det populära ramverket Boost, som skapades för att vara plantskola för framtida datatyper och funktioner i standardbiblioteket för C++.
Den här artikeln visar hur Boost löser problemet ovan i ett enda flöde. Vi hämtar arkivet över HTTPS med Beast, packar upp GZIP-strömmen med Iostreams, tolkar CSV-raderna med Tokenizer och räknar fram statistiken med Accumulators, medan datan strömmar förbi. Programmet byggs i fyra steg, och på vägen stöter vi både på Boost-bibliotek som gör jobbet åt oss och på luckor som tvingar oss att skriva egna komponenter. Demokoden finner du på GitHub i vanlig ordning, se länkarna sist i denna artikel.
Vad programmet ska göra
Det färdiga programmet ska ladda ned en komprimerad TAR-fil innehållande klimatdata över ett år insamlat från många olika väderstationer. Arkivfilen består av CSV-filer, en per väderstation. Varje stationsfil innehåller väderdata för ett helt år, en rad per dag.
Väderdatat tillhandahålls av NCEI vilket står för National Centers for Environmental Information, som utgör en del av NOAA vilket står för National Oceanic and Atmospheric Administration. Det är USA:s federala myndighet för väder, hav och klimat och ligger under handelsdepartementet.
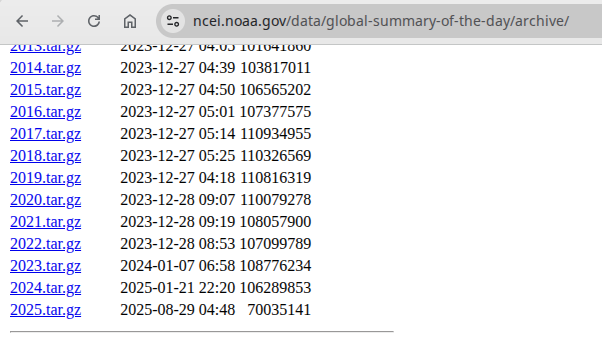
Här finns insamlad väderdata från 1929 fram till 2025. Först från och med 1950-talet så finns det mer fullständig data. Tidigare år har data från betydligt färre väderstationer och somligt är ofullständigt. Datasetet heter GSOD, vilket står för Global Summary of the Day, och innehåller en daglig sammanfattning per station, med bl.a. medel-, min- och maxtemperatur, nederbörd, vind och lufttryck, beräknad ur stationernas timvisa mätningar.
Vissa filer är inte kompletta, utan kan sakna flera dagsrader, och vissa rader kan sakna
fältdata, vilket markeras med nior. Antalet nior beror på precisionen för just den
kolumnen. GSOD använder 9999.9 för TEMP/MAX/MIN och lufttryck, 999.9 för vind, sikt
och snödjup, och 99.99 för nederbörd.
I grova drag ska programmet utföra följande uppgifter:
- Läs in konfigurationsdata
- Läs in kommandoradsargument, vilka kan ersätta somlig konfigurationsdata
- Koppla upp en HTTPS-förbindelse och ladda ned en
*.tar.gzfil för ett visst år - Dekomprimera GZIP-filen
- Packa upp TAR-filen till separata CSV-filer
- Läs och tolka respektive CSV-fil med väderdata
- Aggregera väderdatat för enklare statistisk behandling
- Sammanställ den aggregerade data som ska presenteras
- Skriv ut en textrapport med sammanställningen
- Skriv ut förfluten exekveringstid
Version 1 — CMake, bibliotek, konfiguration
I denna första version, fokuserar jag på att få till katalogstruktur, 3:de parts-biblioteken Boost och Catch2, inläsning av konfigurationsdata. I nästa version börjar vi med filhantering.
CMake
Så här ser CMake-filen i projektkatalogen ut:
cmake_minimum_required(VERSION 3.28)
project(boost_weather_data_demo LANGUAGES CXX)

set(CMAKE_CXX_STANDARD 26)
set(CMAKE_CXX_STANDARD_REQUIRED yes)
set(CMAKE_CXX_EXTENSIONS no)
add_compile_options(-Wall -Wextra -Wpedantic)

find_package(Boost 1.92 CONFIG REQUIRED COMPONENTS
        program_options
        property_tree
)
find_package(OpenSSL REQUIRED)
find_package(Catch2 3 CONFIG REQUIRED)
include(Catch)
enable_testing()

add_subdirectory(version-1)
Den innehåller språkstandard och generella varningsflaggor för kompilatorn, följt av moduler för respektive bibliotek, samt slutligen inkludering av CMake-fil för version 1.
Jag använder här moduler som länkar till redan installerade bibliotek. Se vidare min första artikel om Boost
för olika alternativa vägar att inkorporera biblioteket. Boost består ju av många mindre bibliotek, vilka
representeras i CMake av COMPONENTS. I denna version, är det bara två vi behöver. Men det blir fler i följande
versioner.
Som synes, behövs också OpenSSL, vilket måste installeras i förväg. Boost delegerar all TLS och cert-hantering
till detta bibliotek, vilket är bra ur säkerhetssynpunkt.
Inställningar för CMake görs via en preset-fil (CMakePresets.json), som läses in av både CMake men också min IDE
JetBrains CLion.
{
  "version": 6,
  "cmakeMinimumRequired": { "major": 3, "minor": 28, "patch": 0 },
  "configurePresets": [
    {
      "name": "base",
      "hidden": true,
      "generator": "Ninja",
      "binaryDir": "${sourceDir}/build/${presetName}",
      "environment": {
        "LIBS": "$penv{HOME}/Libs"
      },
      "cacheVariables": {
        "CMAKE_CXX_COMPILER": "/opt/gcc-16.1/bin/g++",
        "Boost_ROOT":  "$env{LIBS}/Boost/latest",
        "Catch2_ROOT": "$env{LIBS}/Catch2/latest"
      }
    },
    {
      "name": "debug",
      "displayName": "Debug",
      "inherits": "base",
      "cacheVariables": { "CMAKE_BUILD_TYPE": "Debug" }
    },
    {...}
  ],
  "buildPresets": [
    { "name": "debug",   "configurePreset": "debug" },
    { "name": "release", "configurePreset": "release" }
  ],
  "testPresets": [...]
}
Den andra CMake-filen är till att börja med tämligen kort
add_executable(weather-data-v1
    app.cxx
)
Själva huvudprogrammet (app.cxx) är inledningsvis befriande kort.
#include <print>
int main(int argc, char** argv) {
    std::println("Weather Data Boost Demo App, version 1");
}
Konfigurationsfil
Detta ska vi nu bygga på med hantering av konfigurationsdata från en fil och hantering av kommandorads-argument. Vi börjar med följande INI-fil, som innehåller samtliga konfigurationsvariabler.
[source]
; The archive-file url for a year is /.tar.gz
url = https://www.ncei.noaa.gov/data/global-summary-of-the-day/archive

[query]
; Year to download, 1929-2025
year = 1950
; Number of stations in the hottest and coldest lists
top = 5

[output]
; Temperature unit in the report: C or F or K
unit = C

[download]
; Set to true to enable caching of downloaded files,
; and to check the cache first before downloading a file
cache = true
; Directory for locally cached archives
cache_dir = ./cache
Boost har ett bibliotek kallat property_tree, som kan hantera konfigurationsfiler i formaten INI, JSON och XML.
Property_tree är i grunden ett generiskt träd där varje nod har ett värde och en ordnad lista av namngivna noder.
Det är ett träd av "properties", som i Javas java.util.Properties, fast hierarkiskt. Konfiguration är bara
det vanligaste användningsfallet.
Biblioteket skrevs av Marcin Kalicinski och kom in i Boost 1.41 (2009). Tanken var en gemensam datamodell för flera textformat:
- Läsarna och skrivarna för INI, JSON, XML och INFO (ett eget Boost-format) är tillägg ovanpå
trädet. Alla läser in till samma
ptree, och man kommer åt data med sökvägar somtree.get<int>("query.year"), oavsett vilket filformat som användes. - Modellen är därför den minsta gemensamma nämnaren för formaten. Värden lagras som strängar och konverteras när de läses. Från JSON försvinner typinformationen, och arrayer blir barn med tomma nycklar.
Så här ser filerna config.hxx och config.cxx ut:
#pragma once
#include <string>
#include <filesystem>

namespace ribomation::weatherdata {
    namespace fs = std::filesystem;

    enum class TemperatureUnit { Celsius, Fahrenheit, Kelvin };

    struct Config {
        std::string     url = "https://www.ncei.noaa.gov/data/global-summary-of-the-day/archive";
        unsigned        year = 1950;
        unsigned        top = 5;
        TemperatureUnit unit = TemperatureUnit::Celsius;
        bool            cache = true;
        fs::path        cache_dir = "./cache";

        static auto load(fs::path const& cfg_file) -> Config;
        static auto parse_unit(std::string const& value) -> TemperatureUnit;
    };

    auto operator<<(std::ostream& os, Config const& c) -> std::ostream&;
}#include "config.hxx"
#include <boost/property_tree/ptree.hpp>
#include <boost/property_tree/ini_parser.hpp>
namespace ribomation::weatherdata {
namespace pt = boost::property_tree;
using namespace std::string_literals;
using std::string;
auto Config::parse_unit(string const& value) -> TemperatureUnit {
if (value == "C") return TemperatureUnit::Celsius;
...
}
auto to_string(TemperatureUnit u) -> string {
if (u == TemperatureUnit::Celsius) return "Celsius";
...
}
auto Config::load(fs::path const& cfg_file) -> Config {
if (not fs::exists(cfg_file)) { ... }
auto cfg = pt::ptree{};
pt::read_ini(cfg_file, cfg);
auto c = Config{};
c.url = cfg.get<string>("source.url", c.url);
c.year = cfg.get<unsigned>("query.year", c.year);
c.top = cfg.get<unsigned>("query.top", c.top);
c.unit = parse_unit(cfg.get<string>("output.unit", "C"));
c.cache = cfg.get<bool>("download.cache", c.cache);
c.cache_dir = cfg.get<string>("download.cache_dir", c.cache_dir);
return c;
}
auto operator<<(std::ostream& os, Config const& c) -> std::ostream& {
os << "-- Config --\n"
<< " url=" << c.url << "\n"
<< ...;
return os;
}
}I main läser vi in konfigurationsfilen och skriver ut innehållet.
auto cfg = Config::load("./weather-data.ini");
std::cout << cfg;
Weather Data Boost Demo App, version 1
-- Config --
url=https://www.ncei.noaa.gov/data/global-summary-of-the-day/archive
year=1950
top=5
unit=Celsius
cache=true
dir=./cacheHantering av kommandoraden (CLI)
För att hantera argument (options) på kommandoraden använder jag Boost Program-Options. Det är ett kolossalt flexibelt och populärt bibliotek för att hantera dylikt. Det skrevs av Vladimir Prus och kom med i Boost 1.32 i november 2004.
På kommandoraden ska man kunna ange årtal (year) och antal (top) väderstationer för att i
sammanställningen visa kallaste och varmaste under året. Dessutom, ska man kunna ange om programmet
bara ska ladda ned (download) och spara en väderdatafil, för senare bruk, samt ange en alternativ
konfigurationsfil (config). Utöver dessa, också få en listning av alla options (help) plus utskrift
av programversionen (version).
Så här ser options.hxx header-filen ut.
#pragma once
#include <string>
#include <optional>
namespace ribomation::weatherdata {
    using std::string;
    using std::optional;
    struct Options {
        bool     download_only = false;
        string   config_file   = "weather-data.ini";
        unsigned year          = 1950;
        unsigned top           = 5;
        static auto parse(int argc, char** argv) -> optional<Options>;
    };
    auto operator<<(std::ostream& os, Options const& c) -> std::ostream&;
}
Implementationsfilen options.cxx utför grovjobbet och parse-funktionen ser ut så här.
#include <boost/program_options.hpp>
namespace po = boost::program_options;

auto Options::parse(int argc, char** argv) -> optional<Options> {
    auto opts = Options{};
    auto cli = po::options_description{APP_NAME};
    cli.add_options()
        ("help,h", "show this help and quit")
        ("version,V", "show version and quit")
        ("year,y", po::value<unsigned>(&opts.year)->required(),
          "the year to process")
        ("top,t", po::value<unsigned>(&opts.top)->default_value(opts.top),
          "number of stations to show coldest/hottest")
        ("download,d", po::bool_switch(&opts.download_only),
          "just download and save/cache the file")
        ("config,c", po::value<string>(&opts.config_file)->default_value(opts.config_file),
          "alt. config file")
        ;

    auto parsed = po::parse_command_line(argc, argv, cli);
    auto values = po::variables_map{};
    po::store(parsed, values);

    if (values.contains("help")) {
        std::cout << cli;
        return std::nullopt;
    }
    if (values.contains("version")) {
        std::println("{}, version {}, step {}", APP_NAME, APP_VERSION, APP_STEP);
        return std::nullopt;
    }
    po::notify(values);

    return opts;
}
Andra raden i funktionen po::options_description{...} skapar ett objekt som sen populeras med
alla tillgängliga CLI options. Operatorn operator() utgör ett intressant sätt att realisera
kaskadanrop på. Vanligtvis returnerar man referensen till sitt objekt med *this och sen via '.'
anropar nästa funktion i kedjan. Här är det i stället funktionsanrops-operatorn på ett hjälpobjekt som
returnerar *this, så att nästa (...) kan följa direkt.
Rent tekniskt så returnerar cli.add_options() ett objekt av typen options_description_easy_init
som innehåller pekaren till cli-objektet (options_description* owner;). Denna klass innehåller
flera överlagrade operator(), vilka vi använder här ovan. Så här ser den enklare av dem ut, så
du har en idé om hur det funkar.
auto operator()(const char* name, const char* description) -> options_description_easy_init& {
  owner->add_option(name, description);
  return *this;
}
De två första options är fristående, med enbart namn på långt (--help) respektive kort variant (-h),
samt en kort beskrivning som visas då man begär hjälptexten.
Den tredje är årtalet (year) och är också obligatorisk (required()). Uttrycket
po::value<unsigned>(&opts.year) skapar ett typed_value<unsigned>*. Pekaren anger var värdet ska
hamna när po::notify(values) anropas. Denna tar argument. Med den långa varianten
kan man skriva --year 1950 eller --year=1950. Och med den korta -y 1950 eller -y1950.
Den fjärde är antalet stationer (top) och har ett skönsvärde default_value(opts.top). Sen fortsätter
det på liknande sätt, tills det är dags att processa argv.
De tre raderna som nu följer tolkar först innehållet i argv, skapar ett tabell-objekt (mycket likt
std::map) och populerar den senare med data från den förstnämnda.
Sedan vidtar kontroll huruvida hjälp eller programversion ska skrivas ut. När funktionen returnerar en tom
std::optional betyder det att huvudprogrammet ska avslutas.
auto opts = Options::parse(argc, argv);
if (not opts) return 0;
Det sista som sker är att Options-objektet populeras med data från values, samt att kontroll av
obligatoriska värden utförs. Om en dylik saknas kastas ett undantag.
Applikationskonstanter
Koden ovan använder sig av tre CPP konstanter APP_NAME, APP_VERSION, APP_STEP, vilka är definierade
i CMake-filen.
project(boost_weather_data_demo
        LANGUAGES CXX
        VERSION 1.0
        DESCRIPTION "Boost Weather-Data Demo"
)
#...
add_compile_definitions(APP_NAME="${PROJECT_DESCRIPTION}")
add_compile_definitions(APP_VERSION="${PROJECT_VERSION}")
I den versions-specifika CMake-filen finns också APP_STEP, plus vilka Boost komponenter som används
add_executable(weather-data-v1
        app.cxx
        config.hxx config.cxx
        options.hxx options.cxx
)
target_link_libraries(weather-data-v1 PRIVATE
        Boost::headers
        Boost::property_tree
        Boost::program_options
)
target_compile_definitions(weather-data-v1 PRIVATE APP_STEP=1)
Nu har jag byggt om huvudprogrammet, så att det ser ut på följande vis
#include <iostream>
#include "config.hxx"
#include "options.hxx"
using ribomation::weatherdata::Config;
using ribomation::weatherdata::Options;

int main(int argc, char** argv) {
    try {
        auto opts = Options::parse(argc, argv);
        if (not opts) return 0;
        std::cout << *opts;

        auto cfg = Config::load(opts->config_file);
        std::cout << cfg;
    } catch (std::exception const& x) {
        std::cout << "Program error: " << x.what() << "\n";
        std::cout << "Use '--help' for help text\n";
        return 1;
    }
}
Kör man programmet kan det se ut så här
$ ./build/debug/version-1/weather-data-v1
Program error: the option '--year' is required but missing
Use '--help' for help text

$ ./build/debug/version-1/weather-data-v1 --help
Boost Weather-Data Demo:
  -h [ --help ]                         show this help and quit
  -V [ --version ]                      show version and quit
  -y [ --year ] arg                     the year to process
  -t [ --top ] arg (=5)                 number of stations to show
                                        coldest/hottest
  -d [ --download ]                     just download and save/cache the file
  -c [ --config ] arg (=weather-data.ini)
                                        alt. config file

$ ./build/debug/version-1/weather-data-v1 --version
Boost Weather-Data Demo, version 1.0, step 1

$ ./build/debug/version-1/weather-data-v1 --year 1960
-- Options --
 year=1960
 top=5
 config=weather-data.ini
 download=false
-- Config --
 url=https://www.ncei.noaa.gov/data/global-summary-of-the-day/archive
 year=1950
 top=5
 unit=Celsius
 cache=true
 dir=./cache
Version 2 — Anrop med HTTPS
Nu är det dags att hämta själva väderdatat. I denna version kopplar programmet upp sig mot NCEI
över HTTPS och laddar ned arkivfilen för ett visst år. Antingen sparas filen på disk (--download),
eller så strömmar den bara igenom programmet, utan att vi kikar inuti. Det sistnämnda kan verka
litet meningslöst, men det är precis det som nästa version bygger vidare på. Då skickar vi
bytes vidare till dekomprimeringen, i stället för att slänga dem.
CMake
Det tillkommer tre Boost-komponenter: beast för HTTP, url för att hantera webbadresser och
iostreams för strömmarna. Beast bygger i sin tur på Asio, som följer med automatiskt.
find_package(Boost 1.92 CONFIG REQUIRED COMPONENTS
        property_tree
        program_options
        beast
        url
        iostreams
)
Jag har också passat på att samla all kod utom main i ett statiskt bibliotek, så att
enhetstesterna kan länka mot exakt samma kod som programmet.
target_link_libraries(weather-data-core-${STEP} PUBLIC
        Boost::headers
        Boost::property_tree
        Boost::program_options
        Boost::beast
        Boost::url
        Boost::iostreams
        OpenSSL::SSL
        OpenSSL::Crypto
)
Som synes, kommer nu OpenSSL till användning. Asio har ingen egen TLS-implementation, utan är ett
tunt C++-lager ovanpå OpenSSL. Eftersom Asio är header-only, är det vårt program som måste länka mot
OpenSSL.
Webbadressen med Boost.URL
Arkivfilen för ett år finns på <url>/<year>.tar.gz, där basadressen kommer från konfigurationsfilen.
Visst, det hade gått att klistra ihop strängar, men Boost har sedan version 1.81 ett bibliotek för
just webbadresser, enligt RFC 3986. Så här ser funktionen ut:
auto http_source::archive_url(string const& base_url, unsigned year) -> urls::url {
    auto u = urls::url{urls::parse_uri(base_url).value()}; // throws if malformed

    auto s = u.segments(); //sequence of path segments
    if (not s.empty() and s.back().empty()) {
        s.pop_back(); //drop last, if empty
    }
    s.push_back(std::format("{}.tar.gz", year));

    return u;
}
Funktionen parse_uri() tolkar adressen och returnerar ett resultatobjekt, där .value() kastar ett
undantag om adressen är felaktig. Sökvägen hanteras som en sekvens av segment, så vi behöver inte bry
oss om snedstreck. Om basadressen slutar med /, blir sista segmentet tomt och plockas bort innan
filnamnet läggs till. Dessutom sköter biblioteket procentkodning av tecken som inte får förekomma i en
adress.
Klassen http_source
Nu kommer vi till hjärtat i denna version. Jag hade inledningsvis tänkt gå igenom klassen rad för rad, men det visade sig att det mesta handlar om Asio — uppkoppling, TLS-handskakning, timeouts och dylikt. Asio kommer att få en egen artikel längre fram, så här nöjer jag mig med att beskriva klassen som en svart låda, med ett tydligt kontrakt. Den kompletta koden finner du på GitHub.
Så här ser header-filen ut:
class http_source : public io::source {
    struct Connection; //forward decl
    shared_ptr<Connection> conn;

public:
    explicit http_source(urls::url_view url);

    auto read(char* buffer, std::streamsize n) -> std::streamsize;
    auto content_length() const -> std::optional<std::uint64_t>;
    // ...
};
Klassen ärver från io::source i Boost.Iostreams, vilket gör den till en så kallad Source. Det är
egentligen bara en klass med en funktion read(buffer, n), som fyller bufferten och returnerar antalet
lästa bytes, eller -1 när det inte finns något mer att läsa. Det är allt som io::copy behöver känna
till, och i nästa version även gzip-dekomprimeringen. Var bytes kommer ifrån bryr de sig inte om.
Alla detaljer kring Asio och Beast ligger gömda i den inre strukturen Connection, som bara
är deklarerad i header-filen och definierad i implementationsfilen. Det har två fördelar: de
tunga header-filerna för Asio och Beast behöver bara kompileras i en enda fil, och användaren av
klassen slipper se dem.
Själva läsningen sker i ett antal lager, där vår klass utgör limmet mellan Iostreams och Beast:
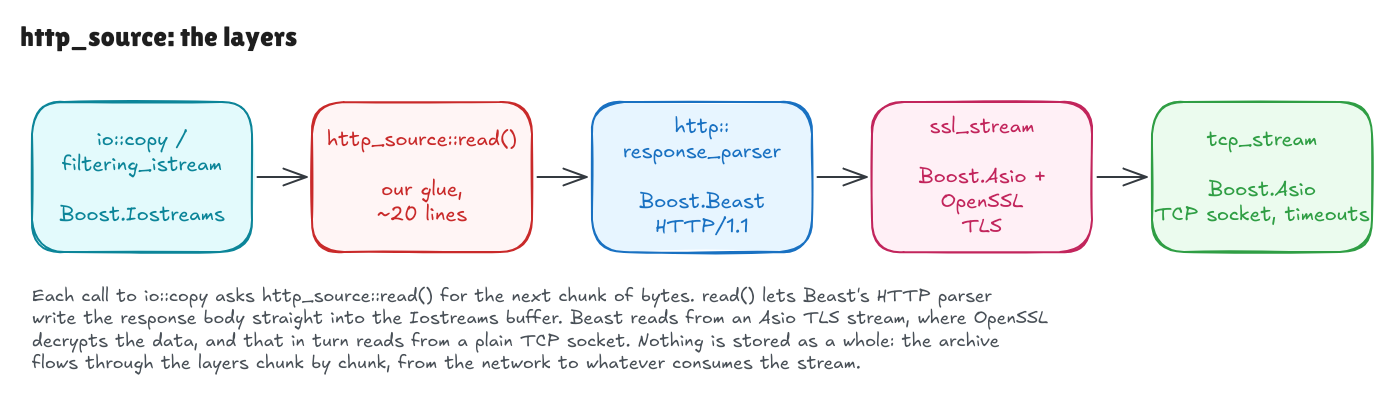
När man skapar ett http_source-objekt utför konstruktorn följande steg:
- Slår upp värdnamnet i DNS och kopplar upp en TCP-förbindelse mot port 443
- Utför TLS-handskakningen, där serverns certifikat verifieras mot systemets certifikatutfärdare och värdnamnet skickas med (SNI)
- Skickar en HTTP-förfrågan,
GET /…/1950.tar.gz - Läser enbart huvudet (header) i svaret, och kastar ett undantag om statuskoden inte är 200
Själva innehållet (body) lämnas oläst, tills någon anropar read(). Då ber vi Beast att läsa nästa
portion, direkt in i den buffert vi fått av Iostreams. Ingenting kopieras i onödan, och arkivfilen
lagras aldrig i sin helhet i minnet.
Det mesta i klassen är rättframt, när man väl vet vad man ska göra. Men det finns tre saker som överraskade mig, och som är värda att känna till.
Beast har en storleksgräns. Som standard vägrar Beast ta emot en body större än 8 MB. Arkivfilerna för senare år är på över 100 MB, så gränsen måste tas bort.
parser.body_limit(boost::none); // the default limit is 8 MB, the archive files are largerFelet need_buffer är inget fel. När Beast har fyllt vår buffert, returnerar läsningen felkoden
need_buffer. Det är så Beast säger till att bufferten är full, och att den gärna vill ha en ny.
if (ec and ec != http::error::need_buffer) {
    throw std::runtime_error{c.url + ": " + ec.message()};
}
Iostreams kopierar sina devices. När man skickar ett http_source-objekt till io::copy eller
lägger det på en filtering_stream, så kopieras det. En nätverksförbindelse går dock inte att kopiera,
så därför ligger Connection bakom en shared_ptr och delas mellan kopiorna.
Nedladdning och huvudprogram
Funktionen download() kopierar från en http_source till en io::file_sink, som är Iostreams
motsvarighet för att skriva till fil. Den skriver först till en temporär fil med ändelsen .part,
och döper om den när allt har gått bra. På så vis blir det aldrig en halvfärdig fil kvar i cachen
om nedladdningen avbryts.
auto partial = fs::path{target} += ".part";
try {
    auto sink = io::file_sink{partial.string(), std::ios::binary};
    if (not sink.is_open()) {
        throw std::runtime_error{"cannot write " + partial.string()};
    }
    io::copy(http_source{url}, sink); //slurp
} catch (...) {
    fs::remove(partial);
    throw;
}
fs::rename(partial, target);
Notera kontrollen med is_open(). Till skillnad från mycket annat i Boost kastar file_sink inget
undantag om filen inte går att öppna.
I huvudprogrammet väljer vi mellan att spara filen eller bara strömma den. I det senare fallet skickas
datat till en io::null_sink, som helt enkelt slänger allt den får. Funktionen io::copy returnerar
antalet kopierade bytes, så vi får ändå veta hur mycket som passerade.
int main(int argc, char** argv) {
    try {
        auto elapsed = Elapsed{};
        auto opts    = Options::parse(argc, argv);
        if (not opts) return 0;
        auto cfg     = Config::load(opts->config_file);

        constexpr auto MB = 1024 * 1024.0;
        auto url  = http_source::archive_url(cfg.url, opts->year);
        auto file = http_source::archive_file(cfg.cache_dir, opts->year);

        std::cout << "fetching " << url << " ...\n";
        if (opts->download_only) {
            auto num_bytes = http_source::download(url, file);
            auto mb = static_cast<double>(num_bytes) / MB;
            std::cout << "saved " << file.string() << " (" << mb << " MB)\n";
        } else {
            auto num_bytes = io::copy(http_source{url}, io::null_sink{});
            auto mb = static_cast<double>(num_bytes) / MB;
            std::cout << "streamed " << mb << " MB\n";
        }
        std::cout << "elapsed " << elapsed.time() << " ms\n";
    } catch (std::exception const& x) {
        std::cout << "Program error: " << x.what() << "\n";
        std::cout << "Use '--help' for help text\n";
        return 1;
    }
}
Kör man programmet kan det se ut så här:
$ ./build/debug/version-2/weather-data-v2 -y 1940
fetching https://www.ncei.noaa.gov/data/global-summary-of-the-day/archive/1940.tar.gz ...
streamed 2.10314 MB
elapsed 1933 ms

$ ./build/debug/version-2/weather-data-v2 -y 1945 -d
fetching https://www.ncei.noaa.gov/data/global-summary-of-the-day/archive/1945.tar.gz ...
saved ./cache/1945.tar.gz (6.00022 MB)
elapsed 1854 ms

$ ./build/debug/version-2/weather-data-v2 -y 1905
fetching https://www.ncei.noaa.gov/data/global-summary-of-the-day/archive/1905.tar.gz ...
Program error: HTTP 404 Not Found for https://www.ncei.noaa.gov/data/global-summary-of-the-day/archive/1905.tar.gz
Use '--help' for help text
Det sista exemplet visar att felhanteringen fungerar: ett år som inte finns ger statuskoden 404, och konstruktorn kastar ett undantag med ett begripligt felmeddelande.
Version 3 — GZIP/TAR/CSV läsning
I denna version av programmet ska vi packa upp innehållet i en hämtad fil. Kom ihåg att filen är komprimerad med GZIP (GNU ZIP), så vi måste dekomprimera först.
Resultatet är sen en TAR-fil. TAR står för Tape ARchive, och är begrepp och filformat som har hängt med sedan UNIX barndom, där man på den tiden gjorde backup till så kallade bandarkiv. Dvs en fysisk bandrulle som sedan lagrades i dedikerade rum. Så en TAR är en fil som innehåller andra filer; sekventiellt ordnade.
Varje sådan fil är i formatet CSV, vilket står för Character Separated Values. Separator-tecknet är oftast komma (','), vilket gör att folk oftast kallar det Comma Separated Values. Så här kan början av en dylik fil se ut:
"STATION","DATE","LATITUDE","LONGITUDE","ELEVATION","NAME","TEMP","TEMP_ATTRIBUTES","DEWP","DEWP_ATTRIBUTES","SLP","SLP_ATTRIBUTES","STP","STP_ATTRIBUTES","VISIB","VISIB_ATTRIBUTES","WDSP","WDSP_ATTRIBUTES","MXSPD","GUST","MAX","MAX_ATTRIBUTES","MIN","MIN_ATTRIBUTES","PRCP","PRCP_ATTRIBUTES","SNDP","FRSHTT"
"01488099999","1960-01-01","60.1166666","10.8333333","170.0","HAKADAL, NO","  42.2","24","9999.9"," 0"," 998.9","24","999.9"," 0","  3.7","24","  7.5","24"," 18.1","999.9","  44.1"," ","  39.9","*"," 0.37","F","999.9","010000"
"01488099999","1960-01-02","60.1166666","10.8333333","170.0","HAKADAL, NO","  40.5","24","9999.9"," 0","1013.1","24","999.9"," 0"," 24.9","24","  5.1","24","  8.0","999.9","  43.0"," ","  39.0"," "," 0.01","E","999.9","000000"
"01488099999","1960-01-03","60.1166666","10.8333333","170.0","HAKADAL, NO","  36.8","24","9999.9"," 0","1023.3","24","999.9"," 0"," 19.4","24","  3.3","24","  7.0","999.9","  39.9"," ","  35.1"," "," 0.02","E","999.9","001000"
"01488099999","1960-01-04","60.1166666","10.8333333","170.0","HAKADAL, NO","  38.1","24","9999.9"," 0","1024.8","24","999.9"," 0","  1.6","24","  5.7","24"," 13.0","999.9","  42.1"," ","  34.0"," "," 0.14","F","999.9","010000"
. . .
istream pipeline
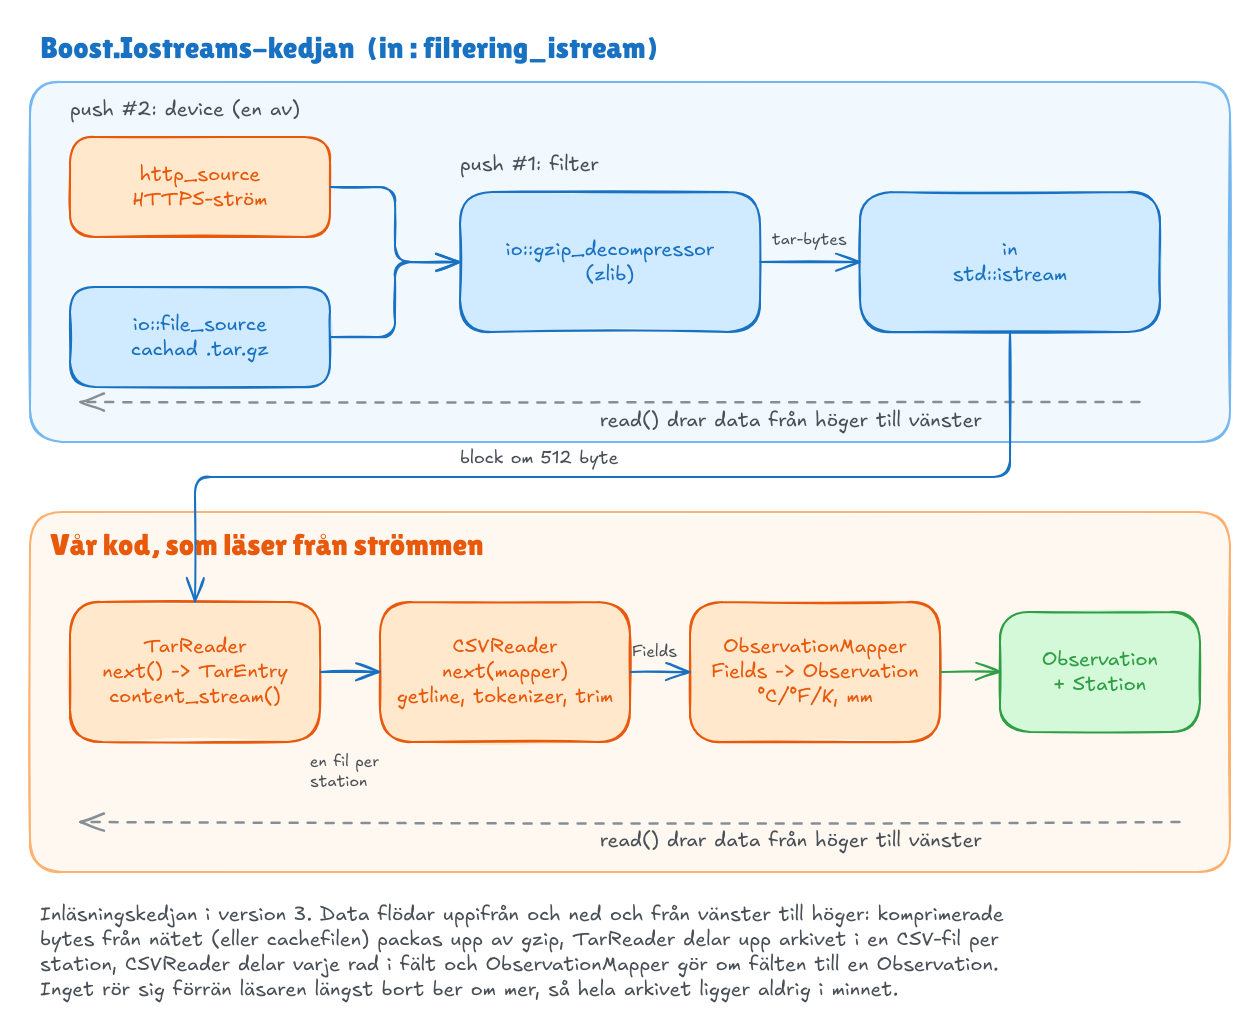
Första halvan i denna del utgörs av en byte-pipeline. Det finns en datakälla, som är
TCP-dataströmmen eller en cachad fil, följt av ett GZIP-dekomprimeringsfilter. Detta exponeras
som en istream, via boost::iostreams::filtering_istream.
Denna indata-ström kopplas sen till en läsare som hanterar en byte-ström i TAR-format. Dessvärre
saknar Boost en komponent som förstår sig på TAR, så det blev till att skriva en egen, kallad
TarReader. Formatet är relativt enkelt; en sekvens av 512-byte block, där varje file-entry
består av ett header-block följt av ett antal content-block. Vid behov paddas sista blocket så att
det blir jämt 512 bytes. Ett arkiv avslutas med två block fyllda med nollor. Detaljerna och
tillhörande enhetstester finns i källkoden och på GitHub. Kolla länksamlingen sist i denna
artikel.
Så här ser det ut rent översiktligt
CSV indata-tolkning och skapandet av Observation-objekt
Andra halvan utgörs av att tolka CSV-data och konvertera varje dylik rad till ett Observation objekt. Ett sådant är kopplat till ett Station objekt. Varje CSV-fil innehåller dagliga sammanställningar av väderdata för en viss väderstation.
struct Station {
    string  id{};
    string  name{};
    double  latitude{};
    double  longitude{};
    double  elevation{};
    auto to_string() const -> string;
    inline static unordered_map<string, Station> repo{};
};

struct Observation {
    constexpr static double missing_temp = 9999.9; // TEMP, MAX, MIN
    constexpr static double missing_prcp = 99.99; // PRCP

    string            station_id{};
    Station*          station = nullptr;
    year_month_day    date{};
    optional<double>  temp_avg{};
    optional<double>  temp_min{};
    optional<double>  temp_max{};
    optional<double>  precipitation{};
    TemperatureUnit   unit = TemperatureUnit::Celsius;
    bool              prcp_mm = true;
    auto to_string() const -> string;
};
Den nya programkoden i app.cxx och main() ser ut så här
auto url = http_source::archive_url(cfg.url, opts->year);
auto file = http_source::archive_file(cfg.cache_dir, opts->year);
// . . .
if (opts->download_only) {
    if (fs::exists(file)) {
        std::cout << "already cached " << file.string() << "\n";
    } else {
        download();
    }
} else if (cfg.cache) {
    if (fs::exists(file)) {
        std::cout << "using cached " << file.string() << "\n";
    } else {
        download();
    }
    pipeline(io::file_source{file.string(), std::ios::binary}, cfg, print);
} else {
    std::cout << "streaming " << url << " ...\n";
    pipeline(http_source{url}, cfg, print);
}
std::cout << "elapsed " << elapsed.to_string() << "\n";
Där jag använder två lambda, eftersom de förekommer på mer än ett ställe i koden.
auto download = [&] {
    std::cout << "fetching " << url << " ...\n";
    auto nbytes = http_source::download(url, file);
    auto mb     = static_cast<double>(nbytes) / MB;
    std::cout << std::format("saved {} ({:.2f} MB)\n", file.string(), mb);
};

auto print = [](Observation& obs) {
    std::cout << obs << "\n";
};
I allt väsentligt har vi en TLS-ström som hanterar HTTPS-delen i ena änden och en print lambda
i andra änden där det trillar ut Observation objekt, en för varje tolkad CSV rad i indata.
Den intressantaste delen här är funktionen pipeline, som skapar en kedja av steg enligt vad
jag beskrev här ovan. Kika noga så ser du att pipeline tar antingen en HTTP-ström eller en
fil-ström.
pipeline(http_source{url}, cfg, print);
//...
pipeline(io::file_source{file.string(), std::ios::binary}, cfg, print);
Den förstnämnda är min egen klass, medan den sistnämnda finns i Boost (boost::iostreams::file_source)
och var inspirationen till den förstnämnda. Funktionen pipeline behöver alltså känna igen och
acceptera olika klasser, som ändå uppfyller samma kriterier om att tillhandahålla en byte-ström.
Detta gör vi med ett C++20 concept, som ser ut så här
template<typename S>
using category_t = typename io::category_of<S>::type;

template<typename S>
concept StreamSource = requires(S src, char* buffer, std::streamsize n)
{
    requires std::copy_constructible<S>;
    requires std::same_as<typename io::char_type_of<S>::type, char>;
    requires std::derived_from<category_t<S>, io::input>;
    requires std::derived_from<category_t<S>, io::device_tag>;
    { src.read(buffer, n) } -> std::same_as<std::streamsize>;
};
static_assert(StreamSource<http_source>);
static_assert(StreamSource<io::file_source>);
En Source i Boost.Iostreams är ingen subklass i objektorienterad mening. Visserligen ärver http_source
från io::source, men det är en tom bekvämlighetsklass som bara definierar char_type och category.
Den har inga virtuella funktioner, och Boost anropar aldrig read() via den. I stället är en Source en
överenskommelse om vilka typer och funktioner som ska finnas, precis som iteratorerna i STL. Concept:et
ovan gör den överenskommelsen synlig i koden. Rad för rad betyder det:
copy_constructible: push() lägger en kopia av src i kedjan, så den måste gå att kopiera. Det är också anledningen till atthttp_sourcehar sin anslutning (conn) i enshared_ptr.char_typeär char: vi läser bytes och inte t.ex. wchar_t (wide char).- Kategorin är
input: dvs det går att läsa från källan. En file_sink som bara kan skrivas till faller bort här. - Kategorin är
device_tag: det är en ändpunkt som producerar data, inte ett filter som behöver något att läsa ifrån. Engzip_decompressorär också input, men har dessutomfilter_tagoch faller därför bort. Det är rätt, eftersom ett filter inte kan stå sist i en pipeline-kedja. read(buffer, n): är den som utför grovjobbet. Funktionen fyller bufferten med upp till n tecken och returnerar antalet som lästes, eller -1 (EOF = End Of File) när det inte finns mer data.
Kategorin är en så kallad tag, en tom struct som bara bär information i själva typen. Taggarna ärver av varandra, och
io::file_source har t.ex. kategorin input_seekable, som i sin tur ärver från input. Därför använder jag std::derived_from
och inte std::same_as. Hjälpfunktionerna category_of och char_type_of är samma traits som Boost själv använder inne i
push(), så concept:et följer bibliotekets egen definition.
De två static_assert-raderna kontrollerar redan vid kompileringen att båda våra källor uppfyller concept:et. Vinsten
med ett concept märks när något är fel. Utan det får man ett långt felmeddelande från djupt inne i Boosts templates,
medan man med ett concept får ett mer precist felmeddelande om vad som är fel.
En fallgrop med requires-block: varje rad måste vara uppfylld, så raderna bildar tillsammans en implicit konjunktion (logical AND). Men en rad som bara består av ett uttryck, t.ex.
std::copy_constructible<S>;, kontrollerar endast att uttrycket kompilerar, inte att det är sant. Den är alltså alltid uppfylld. Det är ordetrequiresframför som gör att värdet utvärderas.
Funktionen pipeline är givetvis en template och begränsar indata-objekt till att uppfylla StreamSource konceptet.
Så här ser denna ut
template<StreamSource Source>
void pipeline(Source src, Config const& cfg, std::function<void(Observation&)> handle) {
    constexpr auto BUF_SIZE = static_cast<std::streamsize>(64 * 1024);

    auto pipe = io::filtering_istream{};
    pipe.push(io::gzip_decompressor{});
    pipe.push(std::move(src), BUF_SIZE);
    pipe.exceptions(std::ios::badbit);

    auto tar = TarReader{pipe};
    while (auto entry = tar.next()) {
        if (not entry->is_file()) continue;

        auto csv    = CSVReader{tar.content_stream()};
        auto mapper = ObservationMapper{cfg.unit, cfg.precipitation_mm};
        while (csv.next(mapper)) { handle(mapper.obs); }
    }
}
Funktionen har tre parametrar. Den första är datakällan (src), som tack vare concept:et StreamSource
kan vara antingen en http_source eller en io::file_source. Funktionen behöver alltså inte veta
om data kommer från nätet eller från cachen. Den andra är konfigurationen (cfg), där vi hämtar
temperaturenhet och om nederbörden ska anges i millimeter. Den tredje är en funktion (handle) som
anropas för varje observation. Det är anroparen som bestämmer vad som ska hända med datat, om
det ska skrivas ut, räknas eller samlas ihop till statistik. Funktionen pipeline() gör bara en
sak: den levererar observations-objekt.
Kedjan
De fyra första raderna bygger Boost.Iostreams-kedjan. En filtering_istream är en vanlig
std::istream, men i stället för att läsa från en fil läser den genom en kedja av länkar som vi
lägger till med push(). Ordningen är viktig: den första länken hamnar närmast den som läser
och den sista längst bort. Den sista måste vara en device, alltså själva källan, och när den
väl är på plats är kedjan komplett.
Här lägger vi först till gzip_decompressor och sedan källan. När någon läser från pipe ber
strömmen gzip-filtret om data, filtret ber i sin tur källan om komprimerade bytes, packar upp
dem och lämnar dem vidare. Data flödar från källan och utåt, medan förfrågningarna går åt
andra hållet. Ingenting händer förrän någon längst ut ber om mer. Detta är en så kallad pull-pipeline,
vilken fungerar på liknande sätt som i Java, där man kan koppla ihop flera objekt som är subklasser
till java.io.InputStream.
Det andra argumentet till push() är buffertstorleken mellan källan och gzip-filtret. Med 64
KiB hämtas den komprimerade datan i stora block, vilket ger få anrop till nätverket eller
disken. Notera också std::move(), eftersom push() tar en kopia av källan.
Raden med exceptions() är lätt att glömma men viktig. Om gzip-filtret stöter på en trasig fil
kastar det ett io::gzip_error, men std::istream fångar normalt alla undantag från sin buffert
och sätter bara badbit. Det ser då ut som ett vanligt filslut, och felet visar sig i stället
som ett obegripligt fel i tar-läsningen. Med badbit påslaget kastas det ursprungliga
undantaget vidare till anroparen.
Arkivet och filerna
Därefter tar min egen kod över. TarReader läser från kedjan som från vilken std::istream som
helst och vet inget om gzip eller nätverk. Varje anrop till next() läser nästa header-block i
arkivet och returnerar en std::optional<TarEntry>, som blir tom när arkivet tar slut. Det är
därför vi kan skriva while (auto entry = tar.next()). Poster som inte är vanliga filer, t.ex.
filkataloger, hoppar vi över.
Varje fil i arkivet är en CSV-fil med data för en väderstation. Metoden content_stream() ger
en std::istream som tar slut exakt där filen tar slut, så CSVReader tror att den läser en helt
vanlig fil. Konstruktorn läser header-raden, så att fälten sedan kan slås upp på namn. Därför
skapar vi en ny CSVReader för varje fil.
Från rad till observation
Den innersta slingan läser en rad i taget. CSVReader::next() delar upp raden i fält och lämnar
dem till ObservationMapper, som översätter dem till en Observation. Mappern tolkar datum och
tal, byter GSOD:s markörer för saknade värden mot tomma optional, och räknar om temperaturen
och nederbörden till de enheter som konfigurationen anger. Till sist anropas handle() med den
färdiga observationen.
Hela kedjan arbetar alltså en rad i taget, och minnesbehovet är detsamma oavsett om arkivet är på 50 eller 500 MB. Hela arkivet finns aldrig i minnet och behöver inte heller sparas på disk först.
Notera att
handle()får en referens till mapperns eget Observation-objekt, som skrivs över (om-populeras) för nästa rad. Vill man spara objektet måste man alltså kopiera det.
CSVReader
Klasserna som hanterar CSV ser ut så här
using Fields      = vector<string>;
using FieldsIndex = unordered_map<string, unsigned>;

struct CSVHeader {
    string      first{};
    FieldsIndex fields_index{};

    void     init(Fields const& header_fields);
    unsigned getIndex(string const& field_name) const;
    bool     isHeader(Fields const& fields) const { return fields[0] == first; }
};

struct FieldsMapper {
    virtual ~FieldsMapper() = default;
    virtual void operator()(CSVHeader const&, Fields const&) = 0;
};

struct CSVReader {
    istream& input;
    CSVHeader header{};

    explicit    CSVReader(istream& input_);
    bool        next(FieldsMapper& mapper) const;
    static auto parse(string const& csv_line) -> Fields;
};
Konstruktorn för CSVReader läser första raden, som är headern med alla fältnamn. Sparar och indexerar dessa,
så att data-raderna kan processas genom att bara plocka ut en liten delmängd av alla fält.
CSVReader::CSVReader(istream& input_): input{input_} {
    auto first_line = string{};
    if (not std::getline(input, first_line)) {
        throw std::runtime_error("missing header line");
    }

    alg::trim(first_line);
    auto header_fields = parse(first_line);
    if (header_fields.empty()) {
        throw std::runtime_error("missing header line");
    }

    header.init(header_fields);
}
//...
void CSVHeader::init(Fields const& header_fields) {
    first = header_fields[0];
    for (auto idx = 0U; idx < header_fields.size(); ++idx) {
        fields_index[ header_fields[idx] ] = idx;
    }
}
//...
bool CSVReader::next(FieldsMapper& mapper) const {
    for (auto csv = string{}; std::getline(input, csv); ) {
        alg::trim(csv);
        if (csv.empty()) continue;

        auto fields = parse(csv);
        if (header.isHeader(fields)) continue;

        mapper(header, fields);
        return true;
    }
    return false;
}
Funktionen CSVReader::next läser nästa giltiga data-rad och skickar denna till mappern. Så länge som det finns
mer data returnerar next true, vilket styr den inre loopen i pipeline, som vi såg tidigare (här återgivet)
while (csv.next(mapper)) { handle(mapper.obs); }Funktionen parse sköter tolkningen av en CSV-rad, med hjälp av Boost-klasser
auto CSVReader::parse(string const& csv_line) -> Fields {
    using Separator = boost::escaped_list_separator<char>;
    auto tokens     = boost::tokenizer<Separator>(csv_line, Separator("", ",", "\""));
    auto fields     = Fields{};
    for (auto const& token : tokens) {
        fields.push_back(alg::trim_copy(token));
    }
    return fields;
}
En rad i GSOD-filerna ser ut ungefär så här:
"02464099999","2024-01-04","59.354","17.94","14.0","BROMMA, SW"," 1.2","24",...Varje fält står inom citattecken, och vissa fält, som stationsnamnet, innehåller själva ett
kommatecken. Det räcker alltså inte att dela raden vid varje komma. Här kommer två delar av
Boost till användning: biblioteket Tokenizer för att dela upp raden och String_algo för att
putsa fälten.
boost::tokenizer tar en sträng och en separator, en funktionsobjektstyp som bestämmer var
gränserna mellan tokens går. Resultatet är ett område (range) som vi kan iterera över med en
vanlig for-loop.
Separatorn escaped_list_separator är designad just för CSV. Dess konstruktor tar tre strängar:
- escape-tecken: här en tom sträng, alltså inget escape-tecken alls. Standardvärdet är bakstreck, och då skulle ett \ i ett stationsnamn tolkas som början på en escape-sekvens.
- separator:
,(dvs ett kommatecken). - citattecken:
"(dvs ett citattecken). Text inom citattecken är ett enda fält även om den innehåller kommatecken, och själva citattecknen tas bort.
Till sist rensar vi varje fält från inledande och avslutande blanktecken med
boost::algorithm::trim_copy(). Talen i GSOD är högerjusterade med mellanslag, t.ex. " 1.2",
och std::from_chars(), som vi använder för att tolka talen, accepterar inte inledande
mellanslag. trim_copy() returnerar en ny sträng och låter originalet vara, medan trim() ändrar
strängen på plats. Den varianten använder vi på hela raden innan den delas upp.
Resultatet blir en std::vector<std::string> med ett fält per kolumn, utan citattecken och
mellanslag.
ObservationMapper
ObservationMapper överbryggar hanteringen mellan CSV-delen —som är hyfsat generell— och Observation
som ju är vår applikationsspecifika datatyp. Klassen ärver från FielsdMapper, som jag visade tidigare men
återger här för att du ska slippa skrolla upp och ned.
struct FieldsMapper {
    virtual ~FieldsMapper() = default;
    virtual void operator()(CSVHeader const&, Fields const&) = 0;
};

struct ObservationMapper : FieldsMapper {
    TemperatureUnit  unit;
    bool             prcp_mm;
    Observation      obs{};

    ObservationMapper(TemperatureUnit unit, bool prcp_mm)
        : unit(unit), prcp_mm(prcp_mm) { }

    void operator()(CSVHeader const& hdr, Fields const& fields) override;
};
Funktionsanropsoperatorn, sist i klassen, är den som hanterar konverteringen från textfält från CSV-tolkningen
till ett Observation-objekt (obs). Den är ganska lång, men i princip hämtar den respektive fält med hjälp av
indexeringen, som ju gjordes i samband med första raden lästes in, samt konverterar till rätt datatyp och i
förekommande fall konverterar till önskad temperaturenhet.
void ObservationMapper::operator()(CSVHeader const& hdr, Fields const& fields) {
    using conversions::parse_optional;
    using conversions::to_measurement;
    using conversions::to_date;
    using conversions::to_unit;
    using conversions::to_mm;
    using conversions::as_string;

    auto station_id = fields.at(hdr.getIndex("STATION"));
    if (not Station::repo.contains(station_id)) {
        auto name = fields.at(hdr.getIndex("NAME"));
        auto lat  = parse_optional(fields.at(hdr.getIndex("LATITUDE")));
        auto lng  = parse_optional(fields.at(hdr.getIndex("LONGITUDE")));
        auto elv  = parse_optional(fields.at(hdr.getIndex("ELEVATION")));
        auto s    = Station{.id = station_id, .name = name,
                            .latitude = lat, .longitude = lng, .elevation = elv};
        Station::repo.emplace(station_id, s);
    }
    obs.station_id = station_id;
    obs.station    = &Station::repo.at(station_id);

    obs.date          = to_date(fields.at(hdr.getIndex("DATE")));
    obs.temp_avg      = to_measurement( fields.at(hdr.getIndex("TEMP")), Observation::missing_temp);
    obs.temp_min      = to_measurement( fields.at(hdr.getIndex("MIN")) , Observation::missing_temp);
    obs.temp_max      = to_measurement( fields.at(hdr.getIndex("MAX")) , Observation::missing_temp);
    obs.precipitation = to_measurement( fields.at(hdr.getIndex("PRCP")), Observation::missing_prcp);

    obs.unit = unit;
    if (obs.temp_avg) obs.temp_avg = to_unit(*obs.temp_avg, obs.unit);
    if (obs.temp_min) obs.temp_min = to_unit(*obs.temp_min, obs.unit);
    if (obs.temp_max) obs.temp_max = to_unit(*obs.temp_max, obs.unit);

    obs.prcp_mm = prcp_mm;
    if (obs.precipitation && obs.prcp_mm) obs.precipitation = to_mm(*obs.precipitation);
}
//...
namespace conversions {
    auto to_date(const std::string& text) -> std::chrono::year_month_day;
    auto to_measurement(string const& field_value, double missing_marker) -> optional<double>;
    auto to_unit(double fahrenheit, TemperatureUnit unit) -> double;
    auto to_mm(double inches) -> double;
    auto parse_double(string const& txt) -> double;
    auto parse_optional(string const& txt) -> optional<double>;
    auto as_string(TemperatureUnit unit) -> string;
}Tjoho, det var ju en hel del programkod. Hela programmet hittar du på GitHub, och länken finns i slutet av artikeln. Det som nu återstår är att aggregera våra insamlade observationer från olika väderstationer och presentera en sammanställning, med hjälp av ytterligare klasser från Boost. Följ med till version 4, som är sista varianten och också det kompletta programmet.
Version 4 — Aggregering av statistik
Det vi ska göra i denna avslutande version av mitt demo-program för Boost, är att sammanställa enklare statistik för inlästa observationer och skriva ut vilka N stationer som hade de högsta respektive lägsta medeltemperaturerna det året. Dessutom ska vi sammanställa antalet lästa bytes både före och efter dekomprimeringen.
Själva statistikhanteringen överlåter vi till en dedikerad Boost komponent Accumulators. Byte-räknandet låter vi en egendefinierad komponent hantera, och den kommer att fungera som ett stream-filter som vi infogar före respektive efter GZIP-filtret.
Till sist använder vi en egendefinierad klass för rapporthanteringen. Nu är det ingen avancerad rapport vi pratar
om här, men det är ändå bra att hålla sig till separation of concern när man programmerar. Tyvärr saknar Boost
någon komponent för text-rapporter. Ett alternativ, skulle kunna vara inja, som är en implementation i modern C++
inspirerad av Jinja och Nunjucks. Den senare använder jag flitigt för att rendera denna webbplats, vilket görs med
Eleventy (11ty), Nunjucks, Node.js, CSS, HTML. Men inja vore overkill för just detta program. Kanske jag återkommer
i annat sammanhang där jag använder detta.
Ny konfigurationsparameter
En komplikation vid aggregeringen är att vissa stationer saknar observationer för hela året. Därför behöver vi
kontrollera att en station har tillräckligt många observationer. Jag har lagt till en ny config-parameter (min_days)
som anger hur många dagar på ett år det ska finnas observationer för som minimum.
[query]
; Year to download, 1929-2025
year = 1950
; Number of stations in the hottest and coldest lists
top = 5
; Min number of days of observations to be considered for aggregation
min_days = 300
struct Config {
std::string url = "...";
unsigned year = 1955;
unsigned top = 5;
unsigned min_days = 300;
//...
};Pipeline Counters
För att räkna antalet bytes har jag skrivit ett eget filter för Boost.Iostreams. Det finns visserligen ett färdigt,
io::counter, men det räknar med int, och då tar det stopp vid 2 GB. Ett års data är redan nästan 1 GB okomprimerat, så
jag valde att skriva ett eget med 64-bitars räknare. Det blev inte många rader:
class byte_counter : public io::multichar_input_filter {
    std::uint64_t count_ = 0;
  public:
    template<typename Source>
    auto read(Source& src, char* buffer, std::streamsize n) -> std::streamsize {
      auto result = io::read(src, buffer, n);
      if (result > 0) count_ += static_cast<std::uint64_t>(result);
      return result; // -1 at EOF, passed on unchanged
    }
    [[nodiscard]] auto count() const { return count_; }
};
Skillnaden mot vår http_source från version 2 är att en device producerar data själv, medan ett filter får sin källa
som parameter och läser vidare från den med io::read(). Filtret vet alltså inte vad som finns bakom, om det är en annan
filterlänk eller själva källan. Basklassen multichar_input_filter sätter rätt kategori, input plus filter_tag.
Det betyder att vårt filter inte uppfyller concept:et StreamSource och därför inte kan stå sist i kedjan, och det är
precis som det ska vara. Filtret lägger vi på ömse sidor om GZIP-filtret, så att vi får både antalet komprimerade och
antalet okomprimerade bytes:
pipe.push(byte_counter{});              // #0: TAR bytes
pipe.push(io::gzip_decompressor{});     // #1:
pipe.push(byte_counter{});              // #2: GZIP bytes
pipe.push(std::move(src), BUF_SIZE);    // #3:
//...
cnt.uncompress_bytes = pipe.component<byte_counter>(0)->count();
cnt.compress_bytes   = pipe.component<byte_counter>(2)->count();
Här finns en liten finess. Eftersom push() tar en kopia av filtret är det kedjans egna exemplar som räknar, inte de
objekt vi skapade. Därför frågar vi kedjan efter dem med component<T>(index), där index följer push-ordningen.
Funktionen returnerar en pekare, som blir nullptr om typen inte stämmer med länken på det indexet. Resultatet samlas
i en enkel struct, PipelineCounters, som funktionen pipeline() nu returnerar.
Aggregator
Statistiken per station hanteras av Boost.Accumulators. Biblioteket bygger på en enkel idé: man talar om vilka
statistiska mått man vill ha, matar in värdena ett i taget och läser av måtten på slutet. Inget av värdena sparas, och
det passar perfekt med vår strömmande inläsning.
class StationStats {
  using Stats = acc::accumulator_set<double,
                                     acc::stats<acc::tag::count, acc::tag::mean,
                                     acc::tag::min,   acc::tag::max>>;
  //...
  Stats temp_{};
public:
  void add(Observation const& obs) {
    ++days_;
    if (obs.temp_avg) temp_(*obs.temp_avg);
  }
  auto mean() const -> double { return acc::mean(temp_); }
  auto min()  const -> double { return acc::min(temp_); }
  //...
};
Måtten anges som taggar i acc::stats<...>, och biblioteket räknar själv ut beroendena mellan dem. mean behöver t.ex.
både count och sum, utan att vi behöver ange detta. Ett värde matas in genom att anropa ackumulatorn som en
funktion, temp_(value), och måtten läses av med fria funktioner som acc::mean(temp_). Det finns många fler mått att
välja bland, som varians, median, kvantiler och skevhet, men för en topplista räcker dessa fyra gott.
Själva klassen Aggregator håller en std::unordered_map från station-id till StationStats, och den skickas direkt
till pipeline() som den funktion som tar emot varje observation. Eftersom alla rader för en station kommer i följd
(en CSV-fil per station) sparar vi en pekare till den aktuella stationen och slår bara upp i map:en när stationen byts:
void Aggregator::operator()(Observation const& obs) {
  ++observations_;
  if (current_ == nullptr || current_->id() != obs.station_id) {
    auto [it, inserted] = stations_.try_emplace(obs.station_id, obs.station_id, obs.station);
    current_ = &it->second; // stable, also when the map rehashes
  }
  current_->add(obs);
}
Rankningen sker sedan med C++20/23 ranges. Vi väljer ut de stationer som har minst min_days dagar med temperatur,
sorterar fram de N första med partial_sort och använder &StationStats::mean som projektion.
Notera att
pipeline()tar emot sin funktionsparameter som enstd::function_ref, som är ny i C++26. Med en vanligstd::functionhade aggregator-objektet kopierats, och all statistik hade då samlats i en kopia som sedan kastas. Enfunction_refrefererar bara till objektet och anropar därmed originalet.
Reporter
För själva utskriften använder vi std::format, eftersom Boost som sagt saknar en komponent för textrapporter. Klassen
Reporter har två funktioner, en för topplistorna och en för sammanfattningen:
out << format("{:>3}  {:<11}  {:<32.32}  {:>6.1f}  {:>6.1f}  {:>6.1f}  {:>4}\n",
              rank++, s->id(), s->name(), s->mean(), s->min(), s->max(), s->count());
Fältbredd och justering ger kolumnerna, ungefär som de gamla rapportformaten i Perl. Ett trick värt att känna till
är {:<32.32}: precisionen på en sträng kortar av den till högst 32 tecken, så ett långt stationsnamn förstör inte
tabellen. Enheten °C skriver vi bara i rubriken, för enkelhetens skull.
Huvudprogrammet (sista versionen)
Funktionen main() innehåller nu både ett aggregator-objekt och ett reporter-objekt, samt tar emot ett
pipeline-counters objekt från funktionen pipeline(). Så här ser nu main ut i sin helhet
int main(int argc, char** argv) {
    auto elapsed = Elapsed{};
    try {
        auto opts = Options::parse(argc, argv);
        if (not opts) return 0;
        auto cfg  = Config::load(opts->config_file);
        auto url  = http_source::archive_url(cfg.url, opts->year);
        auto file = http_source::archive_file(cfg.cache_dir, opts->year);
        constexpr auto MB = 1024 * 1024.0;

        auto download = [&] {
            std::cout << "fetching " << url << " ...\n";
            auto num_bytes = http_source::download(url, file);
            auto mb = static_cast<double>(num_bytes) / MB;
            std::cout << std::format("saved {} ({:.2f} MB)\n", file.string(), mb);
        };

        if (opts->download_only) {
            if (fs::exists(file)) {
                std::cout << "already cached " << file.string() << "\n";
            } else {
                download();
            }
            std::cout << "Elapsed time: " << elapsed.to_string() << "\n";
            return 0;
        }

        auto aggregator = Aggregator{};
        auto cnt        = PipelineCounters{};
        if (cfg.cache) {
            if (fs::exists(file)) {
                std::cout << "using cached " << file.string() << "\n";
            } else {
                download();
            }
            std::cout << "processing file " << file << " ...\n";
            cnt = pipeline(io::file_source{file.string(), std::ios::binary}, cfg, aggregator);
        } else {
            std::cout << "streaming url " << url << " ...\n";
            cnt = pipeline(http_source{url}, cfg, aggregator);
        }

        auto ranking = aggregator.rank(cfg.top, cfg.min_days);
        auto reporter = Reporter{std::cout, cfg};

        auto warmest = std::format("\nThe {} warmest stations in {}",
                                   ranking.warmest.size(), opts->year);
        reporter.ranking(warmest, ranking.warmest);

        auto coldest = std::format("\nThe {} coldest stations in {}",
                                   ranking.coldest.size(), opts->year);
        reporter.ranking(coldest, ranking.coldest);

        reporter.summary(cnt, aggregator, ranking, elapsed);
    } catch (std::exception const& x) {
        std::cout << "Program error: " << x.what() << "\n";
        std::cout << "Use '--help' for help text\n";
        return 1;
    }
}
Kör man programmet med sista året det finns data, så ser det ut så här
$ ./build/debug/version-4/weather-data-v4 -y 2024
streaming url https://www.ncei.noaa.gov/data/global-summary-of-the-day/archive/2024.tar.gz ...

The 5 warmest stations in 2024 (°C)
  #  Station      Name                                Mean     Min     Max  Days
  1  64756099999  ABECHE, CD                          32.9    22.8    42.9   348
  2  81833099999  JAGUARIBE, BR                       32.2    25.8    37.1   341
  3  61265099999  AMBODEDJO, ML                       32.1    23.8    41.9   353
  4  78724099999  CHOLUTECA, HO                       31.6    24.2    38.9   312
  5  41280099999  AL AMERAT, MU                       31.6    18.9    42.7   314

The 5 coldest stations in 2024 (°C)
  #  Station      Name                                Mean     Min     Max  Days
  1  89577099999  DOME PLATEAU DOME A, AY            -56.6   -66.2   -41.5   350
  2  89625099999  CONCORDIA, AQ                      -53.2   -76.8   -23.3   337
  3  89828099999  DOME C II, AQ                      -50.9   -76.0   -18.2   355
  4  89009090001  AMUNDSEN SCOTT, AY                 -48.6   -70.1   -23.5   340
  5  89659099999  PRIESTLEY GLACIER, AY              -36.7   -55.4   -14.9   337
12159 stations (10362 with at least 300 days), 3931419 observations

101.4 MB compressed, 880.0 MB uncompressed, 4 min 47 s (3.1 MB/s)
Försöker man hämta data från senare år, blir man klart besviken...
$ ./build/debug/version-4/weather-data-v4 -y 2025
streaming url https://www.ncei.noaa.gov/data/global-summary-of-the-day/archive/2025.tar.gz ...

The 0 warmest stations in 2025 (°C)
  #  Station      Name                                Mean     Min     Max  Days

The 0 coldest stations in 2025 (°C)
  #  Station      Name                                Mean     Min     Max  Days
11656 stations (0 with at least 300 days), 2528312 observations

66.8 MB compressed, 571.4 MB uncompressed, 3 min 12 s (3.0 MB/s)

$ ./build/debug/version-4/weather-data-v4 -y 2026
streaming url https://www.ncei.noaa.gov/data/global-summary-of-the-day/archive/2026.tar.gz ...
Program error: HTTP 404 Not Found for https://www.ncei.noaa.gov/data/global-summary-of-the-day/archive/2026.tar.gz
Use '--help' for help text
Data för år 2025 är som synes ofullständigt. Av 11 656 väderstationer, så fanns det inga som hade data för 300 dagar eller mera, trots att det fanns cirka 2,5 miljoner observationer. Någon datafil för år 2026 och senare saknas helt.
Sammanfattning
Vi har byggt ett program i fyra steg som hämtar ett helt års väderdata från NOAA, packar upp och tolkar det i ett enda flöde och till sist presenterar en topplista. Under resans gång har ett tiotal Boost-bibliotek fått göra sitt.
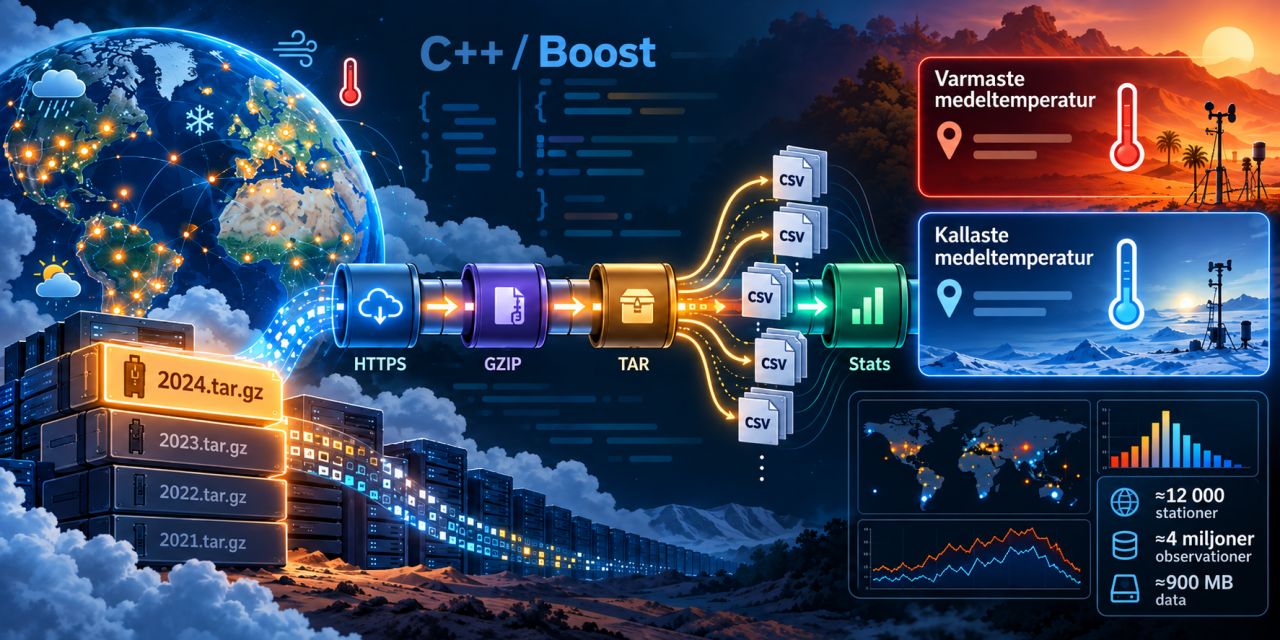
Konfiguration och kommandorad. Property_tree läser in INI-filen och Program_options hanterar kommandoraden.
Tillsammans gav de en enkel modell: konfigurationsfilen innehåller alla inställningar, och på kommandoraden kan man
skriva över ett urval av dem.
Nätverk. URL bygger och plockar isär webbadressen, och Beast, ovanpå Asio och OpenSSL, sköter HTTPS-anropet.
Beast är kraftfullt men medvetet lågnivå. Det märks på detaljer som standardgränsen på 8 MB för svarskroppen och
att need_buffer inte är ett fel. Asio förtjänar en egen artikel, och den kommer.
Strömmar. Iostreams var den röda tråden genom hela programmet. Med filtering_istream och gzip_decompressor
kunde vi bygga en kedja där 880 MB data passerar utan att någonsin ligga i minnet samtidigt. Det var också här vi
lärde oss mest. Boosts begrepp, som Source och Filter, är överenskommelser och inte gränssnitt med
virtuella funktioner. Basklasser som io::source finns, men är bara en genväg för att få rätt typer och
taggar för kategorier. Det gav oss en anledning att skriva ett eget C++20-concept, StreamSource, som gör
överenskommelsen synlig. Vi lärde oss också att push() kopierar, vilket fick konsekvenser både för vår http_source
och för hur vi läser av räknarna med component<T>().
Tolkning och statistik. Tokenizer delar upp CSV-raderna, String_algo putsar fälten och Accumulators räknar
ut medel, min och max per station, ett värde i taget utan att något sparas.
Lika intressant är det som saknades, så att vi fick skriva det själva:
TarReader. Boost kan packa upp GZIP, men kan inte läsa ett TAR-arkiv. Formatet är som tur är enkelt, och vår TarReader blev drygt hundra rader. I produktion hade jag valt biblioteketlibarchive.http_source. Det finns ingen färdig HTTP-device för Iostreams, så denna blev limmet mellan Beast och Iostreams.byte_counter. Ett 64-bitars räknefilter. Det färdigaio::counterräknar med int och slår i taket vid 2 GB.Reporter. Boost har ingen mallmotor för rapporter. Här räcktestd::formatgott, men för större behov finns t.ex.injautanför Boost.
Till sist är det tydligt hur standardbiblioteket successivt har tagit över det som Boost en gång introducerade.
Datumtolkningen klarade vi med std::chrono::parse() i stället för Date_Time. flat_map finns numera i std, och
std::format har ersatt Format. Funktionsparametern i vår pipeline blev en std::function_ref från C++26.
Boost fungerar fortfarande som en plantskola, och ett modernt C++-program använder typiskt både det bästa ur
standardbiblioteket och det som standarden ännu inte har hunnit med.
Jag hoppas att du tyckte denna artikel var både lärorik och insiktsfull och gav dig en allsidig belysning av vad Boost har att erbjuda, samt på vilka områden Boost har "förbättringspotential".
Länkar
- Källkod till artikeln – klona och kör alla fyra versionerna
- Förra artikeln – Kom igång med Boost
- NOAA Global Summary of the Day (GSOD) – beskrivning av datasetet
- GSOD – arkivfiler per år (1929–2025)
- Boost.Beast – HTTP över Asio
- Boost.URL
- Boost.Iostreams
- Boost.Tokenizer
- Boost.Accumulators
- Boost.Program_options
- Boost.Property_tree
- Catch2 – ramverk för enhetstester
Senaste Artiklarna
-
Väderdata med Boost
15 oktober 2026 -
Kom igång med Boost
2 oktober 2026 -
C++26 ORM via Reflection
29 september 2026 -
C++26 Reflection
18 september 2026 -
C++26 Contracts
11 september 2026 -
Cargo – konvention framför konfiguration
4 september 2026 -
Referenser & pekare i Rust jämfört med C++
28 augusti 2026 -
När Rust får panik gör C++ ett undantag
21 augusti 2026