
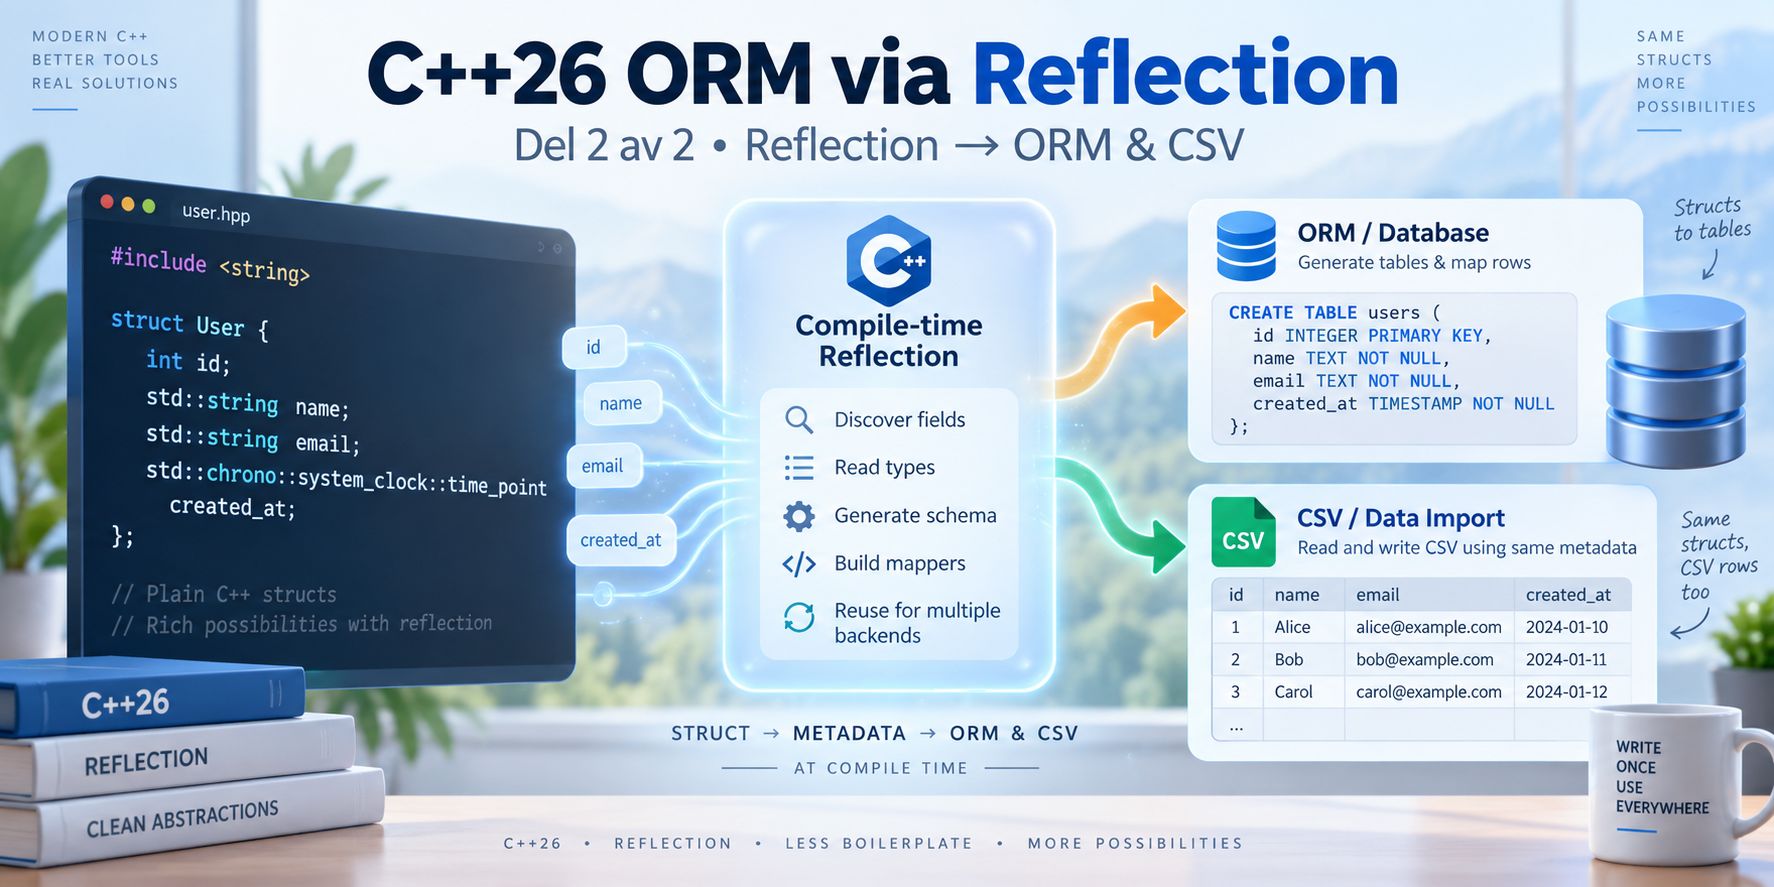
Tänk dig att du deklarerar en helt vanlig struct, strör några annoteringar över den — och sedan kan skapa tabellen, spara objekt, köra typade queries och få tillbaka färdiga objekt, utan att skriva en enda rad SQL. Det har Java-programmerare tagit för givet i snart tjugo år. I C++ har det varit omöjligt. Fram till nu.
I förra artikeln gick jag igenom hur compile-time reflection i C++26 fungerar. Den här gången sätter jag den på prov, genom att bygga ett litet men fullt fungerande ORM-ramverk, i stil med Hibernate/JPA, som pratar med både PostgreSQL och SQLite. På vägen dit stötte jag på ett hinder jag aldrig hade förutsett, och avslutningsvis läser vi in tusen personer från en CSV-fil, stoppar in dem i databasen och spottar ut resultatet som JSON — allt med samma reflektiva teknik.
UPDATE: 2026-09-29
Denna artikel här en helt komplett omskrivning av den text jag publicerade i fredags (25 sept). Efter genomläsning några dagar senare, ansåg jag att första versionen var helt undermålig. Så, om du redan läst fredagens version, kan jag varm rekommendera att läsa denna på nytt.
ORM - Object Relational Mapping
I takt med att relationsdatabaser, såsom MySQL, blev mer vanliga under 1990-talet så började folk tröttna på att skriva liknande kod om och om igen för typiska CRUD-operationer. Denna akronym står för Create, Read, Update, Delete och utgör fundamentet för att spara och hantera objekt i en databas.
Om vi har en kontoklass (Account), så kan en klassdeklaration och motsvarande SQL tabelldefinition
plus de fyra CRUD operationerna se ut så här:
struct Account {
    long         id{};
    std::string  iban{};
    double       balance{};
};
CREATE TABLE accounts (
id INTEGER AUTOINCREMENT,
iban VARCHAR(32) NOT NULL,
balance DOUBLE PRECISION NOT NULL,
PRIMARY KEY ("id")
);
-- CREATE
INSERT INTO accounts ("iban", "balance") VALUES ("ABCD-1234-5678", 1000.0);
-- READ
SELECT "id", "iban", "balance" FROM accounts WHERE id=123
-- UPDATE
UPDATE accounts SET "balance"=2500.0 WHERE id=123
-- DELETE
DELETE FROM accounts WHERE id=123I slutet på 1990-talet skapades EJB standarden för Java applikationer, där akronymen står för Enterprise Java Bean och det fanns inledningsvis två typer; Session EJB och Entity EJB. Den förstnämnda var tänkt för transaktionella affärsoperationer och den sistnämnda för objektavbildning till och från databasen. För att kunna implementera affärssystem med EJB, krävdes en speciell typ av exekveringsmiljö, kallat applikationsservrar. Åren efter millennieskiftet blev dylika servrar populära såsom Weblogic och JBoss.
Emellertid, var det kolossalt omständligt att skriva EJB applikationer, där man fick skriva stora mängder XML kod för att instruera servrar om hur de skulle hantera alla EJB varianter.
Under 2003 arbetade jag med att bygga betallösningar och påfyllnadssystem för kontantkortstelefoner, och hade tröttnat rejält på EJB och allt trassel runt omkring detta. Jag hade då ut av ren desperation byggt mitt eget system för att avbilda objekt till och från en MySQL-databas.
I slutet av det året fick jag syn på ett nytt och lovande projekt kallat Hibernate och beslöt att använda detta för nästa projekt. Vi fick med kort varsel vara med i anbudsgivningen för en upphandling hos Jordbruksverket, angående betalning via mobiltelefon. Kom ihåg att detta var flera år innan smartphones kom. Jag föreslog till vår affärsutvecklare att varför skriva en massa text om hur vi skulle vilja göra, i stället för att visa dem en prototyp man kunde interagera med direkt.
Sagt och gjort, med hjälp av Hibernate, Tomcat och JSP byggde jag en applikation, som fungerade ihop med vårt tonvalsystem. Affärsutvecklaren åkte sen till Jönköping, demonstrerade ett mer eller mindre färdigt system genom att utföra en (simulerad) betalning via en mobil (tonval) och verifiera detta i det användargränssnitt jag satt upp. Detta imponerade så pass mycket på kunden att vi fick uppdraget strax därefter.
Det här var min första kontakt med ett riktigt ORM-system (Object Relational Mapping) och jag kastade EJB på skräphögen där jag tyckte det passade. Under årens lopp har jag jobbat med Hibernate, GORM (Groovy ORM) och andra liknande system, och i flera andra programspråk än Java.
När annotations kom i Java 5, började jag experimentera med att annotera Java-klasser och via reflektion i runtime generera avbildningsbeskrivningar i XML för Hibernate. Det var fler än jag som hade samma idé, och detta medförde en genomgripande pivotering av hur man skrev dylika program, och med tiden banade väg för JPA (Java Persistence API).
@Entity
@Table(name = "accounts")
public class Account {
    @Id @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @Column(name = "iban", nullable = false, unique = true, length = 34)
    private String iban;

    @Column(name = "balance", nullable = false, precision = 19, scale = 4)
    private BigDecimal balance;

    protected Account() {}
    public Account(String iban, BigDecimal balance) {
        this.iban = iban;
        this.balance = balance;
    }

    public Long getId() { return id; }
    public String getIban() { return iban; }
    public BigDecimal getBalance() { return balance; }
    public void setBalance(BigDecimal balance) { this.balance = balance; }

    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (!(o instanceof Account other)) return false;
        return iban != null && iban.equals(other.iban);
    }

    @Override
    public int hashCode() { return getClass().hashCode(); }
}
ORM i Modern C++
Från första stund jag kunde börja experimentera med reflections i C++26, så var min tanke att skulle det vara möjligt att bygga något liknade Hibernate/JPA i C++. Om detta handlar resten av denna artikel.
I min förra artikel beskrev jag hur compile-time reflection i C++26 fungerar, inklusive annoteringar. Så här kan några annoteringar se ut:
struct Table {
    compiletime_string name{};
};

struct Column {
    compiletime_string  name{};
    compiletime_string  sql_type{};
    Nullable            nullable = Nullable::derive;
    compiletime_string  default_value{};
};

struct PrimaryKey {
    compiletime_string sql_type{};
    bool auto_increment = false;
};

enum class Nullable { derive, yes, no };
Som synes är det enkla structs, en enum, samt en specialversion för textsträngar. Jag återkommer till denna, senare i artikeln. Med hjälp av dessa annoteringar kan vi dekorera en struct som beskriver ett mycket enkelt bankkonto, så här:
#include <tiny-orm/schema.hxx>
#include <tiny-orm/ddl.hxx>
#include <tiny-orm/dml.hxx>
#include <string>
#include <optional>
#include <print>

namespace orm = tiny_orm;
using std::optional;
using std::string;

struct [[=orm::Table{}]] Account {
    [[=orm::PrimaryKey{.auto_increment = true}]]
    long id{};

    [[=orm::Column{.sql_type = "CHAR(32)"}]]
    string iban{};

    [[=orm::Column{.nullable = orm::Nullable::yes, .default_value = "0.0"}]]
    double balance{};

    optional<string> nickname{};
};
Tack vare designated initializers, som kom i C++20, så kan man omdefiniera de egenskaper i respektive annotering, vilka behöver ha avvikande värden jämfört med sina standardvärden (default values).
struct PrimaryKey {
    compiletime_string  sql_type       = "";
    bool                auto_increment = false;
};
auto annotation = orm::PrimaryKey{.auto_increment = true};
Generering av SQL
Så klassen dekoreras med orm::Table{}, medan, till exempel, fältet iban dekoreras med Column{.sql_type = "CHAR(32)"}
för att fixera vilken SQL-typ som ska användas vid generering. Inte alla fält behöver annoteras, såsom nickname.
Eftersom denna utgör en optional<string> så blir den valfri (NULL) vid generering, medan balance blir det inte
(NOT NULL).
Kör vi programmet, som koden ovan är en del av, kan SQL-koden för motsvarande tabell se ut så här, där jag valt att generera för PostgreSQL.
CREATE TABLE IF NOT EXISTS "accounts" (
  "id" BIGINT GENERATED BY DEFAULT AS IDENTITY NOT NULL,
  "iban" CHAR(32) NOT NULL,
  "balance" DOUBLE PRECISION DEFAULT 0.0,
  "nickname" TEXT,
  PRIMARY KEY ("id")
);
SQL-koden för ovanstående fås med funktionen create_table_sql:
auto dialect = orm::psql_dialect{};
auto sql1 = orm::create_table_sql<Account>(dialect);    //define
auto sql2 = orm::drop_table_sql<Account>(dialect);      //erase
Vill man stoppa in ett nytt objekt, görs det med funktionen insert_object:
auto acc = Account{.iban = "ABC-1234-5678"s, .balance = 1500.0, .nickname = "vacation"s};
auto sql = orm::insert_object(acc, dialect);
INSERT INTO "accounts" ("iban", "balance", "nickname") VALUES ($1, $2, $3) RETURNING "id";
params: ['ABC-1234-5678', '1500', 'vacation']Givet att man har primärnyckeln för ett objekt, så kan man läsa in det, uppdatera det och radera det.
auto pk = 123L;
auto sql1 = orm::load_by_key<Account>(pk, dialect);
acc.balance *= 10;
auto sql2 = orm::update_by_key(pk, acc, dialect)
auto sql3 = orm::delete_by_key<Account>(pk, dialect);
-- Read
SELECT "id", "iban", "balance", "nickname" FROM "accounts" WHERE "id" = $1;
params: ['123']
-- Update
UPDATE "accounts" SET "iban" = $1, "balance" = $2, "nickname" = $3 WHERE "id" = $4;
params: ['ABC-1234-5678', '15000', 'vehicle', '123']
-- Delete
DELETE FROM "accounts" WHERE "id" = $1;
params: ['123']
En SQL query byggs upp stegvis (builder pattern), där förekommande medlemmar (properties) identifieras med hjälp av cat-ear operator.
constexpr auto balance = orm::field<^^Account::balance>;
show_sql("Query", orm::from<Account>(dialect)
         .where(balance > 1000.0)
         .order_by(balance, orm::sort::desc)
         .limit(5)
         .to_sql()
);
SELECT "id", "iban", "balance", "nickname" FROM "accounts"
WHERE "balance" > $1
ORDER BY "balance" DESC
LIMIT $2;
params: ['1000', '5']Implementering
Hela demo-koden finns på GitHub (se länkavsnittet sist i artikeln), så jag kommer bara ta upp vissa delar av denna här.
Det som inledningsvis är knepigt är att hålla kolla på vilken kod som utförs i compile-time och vilken som utförs i run-time,
samt vilken typ av information som ska överföras från den förstnämnda till den sistnämnda.
Låt oss börja med en av de enklaste funktionerna, den som genererar en SQL DELETE.
template<typename T, typename K>
auto delete_by_key(K const& k, dialect const& sql) -> statement {
    constexpr auto tbl = detail::table_name(^^T).view();
    constexpr auto key = detail::primary_key_column<T>().name.view();
    auto const fragment = std::format("DELETE FROM {} WHERE {} = ?;",
                                      detail::mark_id(tbl),
                                      detail::mark_id(key));
    return {detail::render(sql, fragment), {detail::to_param(k)}};
}
Template-parametrarna är typer för entitet och primärnyckel.
Tabellnamnet
Det första som utförs är att ta reda på tabellnamnet.
constexpr auto tbl = detail::table_name(^^T).view();
//...
consteval auto table_name(std::meta::info type) -> compiletime_string {
    if (auto const t = annotation_on<Table>(type); t && !t->name.empty()) return t->name;
    return to_plural(to_snake(std::meta::identifier_of(type)));
}
Om det finns ett explicit namn, använd detta. Annars, ta struct-namnet, gör det om till snake_case samt till dess
pluralform. Detta returnerar en compiletime_string, som jag lovade att återkomma till.
Hantering av text i compile-time
Innan något över huvud taget kunde byggas dök ett problem upp som jag inte hade förutsett: en sträng måste kunna existera som en konstant.
Det här låter förvisso som ett icke-problem. Ett kolumnnamn är en sträng, ett tabellnamn är en
sträng, och båda är också kända vid kompileringen. Men en sträng som utgör payload för en annotering, ett
template-argument eller ett element i std::define_static_array måste klara två helt
oberoende hinder.
| Hinder | Kravet | Funkar inte för | Lösningen |
|---|---|---|---|
| 1 | typen är strukturell | std::string_view, std::span |
publika medlemmar |
| 2 | värdet är en tillåten konstant | pekare till strängliteraler | std::define_static_string |
En klass är strukturell när den är en literal typ och varje basklass och
icke-statisk datamedlem är public och icke-mutable, rekursivt. Det handlar om
åtkomstkontroll, inte om layout. Så, även om std::string_view hade varit perfekt för detta, så
kan den inte användas eftersom dess medlemsvariabler är privata, och inte publika.
En pekare som används som konstant måste peka på ett objekt med statisk lagring som språket kan namnge. En stränglitteral är inte ett sådant objekt — den har ingen egen plats i symboltabellen, och kompilatorer får slå ihop eller duplicera literaler fritt. Så även en perfekt strukturell typ blir avvisad:
struct sv { const char* data; unsigned long size; };   // strukturell, OK
template<sv S> struct T {};
using X = T<sv{"users", 5}>;
error: '"users"' is not a valid template argument of type 'const char*'
because '"users"' is not a variable or functionstd::define_static_string() finns precis för att ta sig igenom det här hindret: den
kopierar tecknen till en riktig array med statisk lagring och returnerar en pekare
som går att namnge. Resultatet blev en egen datatyp, som förhoppningsvis blir en del av
reflection-typerna i senare versioner av C++. Så här ser min ut, notera att det finns en
transformations-funktion vilken returnerar en std::string_view.
struct compiletime_string {
    const char* data = nullptr;
    std::size_t size = 0;
    constexpr bool empty() const { return size == 0; }
    constexpr auto view() const -> std::string_view { return {data, size}; }
};
static_assert(std::is_structural_v<compiletime_string>);

consteval auto S(std::string_view s) -> compiletime_string {
    return { std::define_static_string(s), s.size() };
}
Ytterligare en märklighet dök upp. define_static_string är innehållsadresserad;
samma text ger alltid samma pekare (adress). Det betyder att ett kolumnnamn som härletts reflektivt
ur fullName och ett handskrivet "full_name" namnger samma instansiering, istället för att tyst
generera två olika.
static_assert(lower("USERS") == std::define_static_string("users"));
static_assert(std::is_same_v<T<lower("USERS")>, T<std::define_static_string("users")>>);
Den ergonomiska baksidan är att varje sträng måste promoveras (dvs göras länkbar), även literaler
som returneras från egna consteval-funktioner. Det kostar en felsökningsrunda varje
gång man glömmer:
consteval auto sql_type(std::meta::info t) -> const char* {
    if (t == ^^int) return "INTEGER";                            // reflect_constant failed
    if (t == ^^int) return std::define_static_string("INTEGER"); // kompilerar
    //...
}
Primärnyckelsnamnet
Det andra, i delete-funktionen, är att leta fram namnet för primärnyckeln.
constexpr auto key = detail::primary_key_column<T>().name.view();
//...
template<typename T>
consteval auto primary_key_column() -> column_info {
    for (auto const& c : columns_of<T>()) if (c.primary_key) return c;
    throw std::meta::exception{"..."};
}
Här ser vi användning av en fundamental datatyp i ramverket, nämligen column_info,
och den ser ut så här:
struct column_info {
    compiletime_string  name{};
    type_kind           kind = type_kind::text;
    compiletime_string  sql_type{};
    bool                nullable = false;
    compiletime_string  default_value{};
    bool                primary_key = false;
    bool                auto_increment = false;
    compiletime_string  references_table{};
    compiletime_string  references_column{};
    FkAction            on_delete = FkAction::none;
};
static_assert(std::is_structural_v<column_info>);

enum class type_kind {boolean, int16, int32, int64, float32, float64, text, timestamp};
enum class FkAction {none, no_action, restrict_, cascade, set_null, set_default}
Tentativ SQL
Det tredje som utförs i delete-funktionen är sammansättning av SQL-satsen, där de två parametrarna (table, pk) markeras i textsträngen, så att sista steget kan identifiera dessa och ersätta med dialektal SQL-fragment.
auto const fragment = std::format("DELETE FROM {} WHERE {} = ?;",
                                  detail::mark_id(tbl),
                                  detail::mark_id(key));
//...
// id_mark is a non-printable ASCII char
inline auto mark_id(std::string_view identifier) -> std::string {
    return std::string{id_mark} + std::string{identifier} + id_mark;
}
Dialektal SQL
Sista steget skapar ett statement-objekt, som består av SQL plus parametrar.
struct statement {
    std::string sql;
    std::vector<param> params;
};
using param = std::optional<std::string>;
//...
return {detail::render(sql, fragment), {detail::to_param(k)}};
//...
inline auto render(dialect const& sql, std::string_view fragment) -> std::string {
    auto out = std::string{};
    auto n = 0;
    for (auto i = 0uz; i < fragment.size(); ++i) {
        if (fragment[i] == id_mark) {
            auto const end = fragment.find(id_mark, i + 1);
            out += sql.quote(fragment.substr(i + 1, end - i - 1));
            i = end;
        } else if (fragment[i] == '?') {
            out += sql.placeholder(++n);
        } else {
            out += fragment[i];
        }
    }
    return out;
}
//...psql_dialect...
auto quote(std::string_view id) const -> std::string override {
    return std::format("\"{}\"", id);
}
auto placeholder(int n) const -> std::string override {
    return std::format("${}", n);
}
//...
template<typename V>
auto to_param(V const& v) -> param {
    if constexpr (requires { v.has_value(); *v; })
        return v.has_value() ? to_param(*v) : param{};
    else if constexpr (std::same_as<V, bool>)
        return v ? "1" : "0";
    else if constexpr (std::convertible_to<V const&, std::string_view>)
        return std::string{std::string_view{v}};
    else if constexpr (requires { typename V::clock; })
        return std::format("{:%F %T}", std::chrono::floor<std::chrono::microseconds>(v));
    else
        return std::format("{}", v);
}
Koppling till databas
Den andra halvan av ramverket kopplar till en riktig databas. Jag har valt att implementera stöd för två olika databaser, nämligen PostgreSQL och SQLite3. Behöver du en tredje, bör du kunna klura ut detta genom att kika i koden:
src/tiny-orm/dialect.hxxsrc/tiny-orm/connection.hxxsrc/tiny-orm/connect.hxxsrc/tiny-orm/psql.hxxsrc/tiny-orm/sqlite.hxx
Anslutning till DB
Första steget är att etablera en anslutning till en database, vilket gör med hjälp av en
databas-specifik URL skickat till fabriksfunktionen connect.
constexpr auto URL = "postgresql://orm:orm@localhost:5432/tiny_orm_test";
auto conn = db::connect(URL);
Denna funktion, inspekterar URL:en och väljer implementerande klass returnerad i en smart pekare.
auto connect(std::string_view url) -> std::unique_ptr<connection> {
    auto const starts_with = [url](std::string_view prefix) {
        return url.starts_with(prefix);
    };
    if (starts_with("postgresql://") || starts_with("postgres://")) {
#ifdef TINY_ORM_HAS_POSTGRES
        return std::make_unique<psql_connection>(std::string{url});
#else
        throw db_error{"..."};
#endif
    }
    if (starts_with("sqlite:")) {
#ifdef TINY_ORM_HAS_SQLITE
        return std::make_unique<sqlite_connection>(std::string{url.substr(7)});
#else
        throw db_error{"..."};
#endif
    }
    throw db_error{"..."};
}
Här syns det tydligt vilka databaser det finns stöd för, via villkorlig kompilering.
Klassen psql_connection är subklass till connection, där konstruktorn ansluter och
destruktorn kopplar bort.
class psql_connection final : public connection {
    PGconn* conn_ = nullptr;
    psql_dialect dialect_{};
public:
    explicit psql_connection(std::string const& url) {
        conn_ = PQconnectdb(url.c_str());
        if (PQstatus(conn_) != CONNECTION_OK) { /*...*/ }
    }
    ~psql_connection() override {
        if (conn_ != nullptr) PQfinish(conn_);
    }
    //...
};
DAO - Data Access Object
DAO är ett designmönster som isolerar all databasåtkomst via ett vanligt objektgränssnitt. Istället för att strö SQL-satser över hela applikationen samlar man dem i en klass per entitet, vilken har ett antal CRUD-funktioner, plus eventuella query-funktioner.
struct Person {
    std::string  name{};
    //...
};

struct PersonDAO {
    void            insert(const Person&);
    void            update(const Person&);
    void            remove(int id);
    std::optional<Person> findById(int id);
    std::vector<Person>   findAll();
};
Anropande kod ser bara Person-objekt in och ut — inga tabeller, inga kolumnnamn, inga SELECT-strängar. Fördelarna är flera:
- Separation av ansvar. Affärslogik i ett lager, persistens i ett annat.
- Utbytbarhet. Byt SQLite mot PostgreSQL, eller mot en in-memory-mock i testerna, utan att röra resten av koden.
- Ett ställe att ändra på. Nytt fält i tabellen? Bara DAO:n berörs.
Mönstret kommer ursprungligen från Java/J2EE-världen kring millennieskiftet, men idén är generell och lever vidare i allt från Python till Rust. En ORM (Object-Relational Mapper) kan ses som ett automatiserat DAO — istället för att handskriva CRUD-metoderna genereras de åt dig. Det är detta vi ska kika på nu med hjälp av modern C++.
Skapa DAO-objekt och databas-tabeller
Med hjälp av ett connection-objekt kan vi skapa ett DAO-objekt. Med denna kan vi både generera SQL-kod för att skapa en tabell och radera denna i slutet.
auto dao = db::DAO<Person>{*conn};
dao.create();
//...
dao.drop();
DAO-klassen kan se ut så här:
template<typename T>
class DAO {
    connection* db_;
public:
    using key_type = typename[:std::meta::type_of(detail::primary_key_member<T>()):];
    explicit DAO(connection& db) : db_{&db} {}
    void create(ddl_options opt = {}) {
        db_->execute(create_table_sql<T>(db_->sql_dialect(), opt));
    }
    void drop(drop_options opt = {}) {
        db_->execute(drop_table_sql<T>(db_->sql_dialect(), opt));
    }
    void insert(T& e) {...}
    auto insert_all(std::vector<T>& rows, bulk_options opt = {}) -> long {...}
    auto load(key_type const& k) const -> std::optional<T> {...}
    auto update(T const& e) -> long {...}
    auto remove(key_type const& k) -> long {...}
    bool exists(key_type const& k) const {...}
    auto count() const -> long {...}
    auto select() const -> query<T> {...}
Låt oss följa anropskedjan från funktionen create. Först anropas execute(sql), som anropar den abstrakta
metoden execute(statement), vilken realiseras av klassen psql_connection. Där genomförs anropet och ett
result_set objekt populeras och returneras.
dao.create();
//...
void DAO::create(ddl_options opt = {}) {
    db_->execute( create_table_sql<T>(db_->sql_dialect(), opt) );
}
//...
auto connection::execute(std::string sql) -> result_set {
    return execute(statement{std::move(sql), {}});
}
virtual auto connection::execute(statement const& s) -> result_set = 0;
//...
auto psql_connection::execute(statement const& s) -> result_set override {
    auto values = std::vector<char const*>{};
    values.reserve(s.params.size());
    for (auto const& p : s.params) values.push_back(p ? p->c_str() : nullptr);

    auto const res = detail::psql_result{PQexecParams(conn_,
                                            s.sql.c_str(),
                                            static_cast<int>(values.size()),
                                            nullptr,
                                            values.data(),
                                            nullptr,
                                            nullptr,
                                            0 /* text results */)};
    switch (PQresultStatus(res.get())) {
        case PGRES_TUPLES_OK:  return to_result_set(res.get());
        case PGRES_COMMAND_OK: return result_set::affected(std::atol(PQcmdTuples(res.get())));
        default: throw db_error{..."};
    }
}
//...
class result_set {
    std::vector<std::string> columns_{};
    std::vector<std::vector<cell>> rows_{};
    long affected_ = 0;
public:
    result_set() = default;
    static auto affected(long n) -> result_set {
        auto rs = result_set{}; rs.affected_ = n; return rs;
    }
    //...
};
//...
class psql_result { //simple RAII
    PGresult* raw_ = nullptr;
public:
    explicit psql_result(PGresult* raw) : raw_{raw} {}
    ~psql_result() { if (raw_ != nullptr) PQclear(raw_); }
    psql_result(psql_result const&) = delete;
    auto operator=(psql_result const&) -> psql_result& = delete;
    auto get() const -> PGresult* { return raw_; }
};
Komplett program
Här följer ett litet men komplett program, med tillhörande utdata. Programmet förutsätter att det finns en PostgreSQL databas igång. I demo-repo:n finns ett docker compose script du kan använda, som kickar igång en dylik.
$ docker compose -f docker/docker-compose.yml up -d
$ docker compose -f docker/docker-compose.yml ps
NAME          IMAGE                ...   STATUS                PORTS
tiny-orm-db   postgres:18-alpine   ...   Up 4 days (healthy)   0.0.0.0:5432->5432/tcp
Data-definition
struct [[= db::Table{} ]] Person {
    [[=db::PrimaryKey{.auto_increment = true}]]
    long id{};

    [[= db::Column{.sql_type = "VARCHAR(32)"} ]]
    string name{};

    int age{};

    [[= db::Column{.default_value = "true"} ]]
    optional<bool> female{};

    optional<string> address{};
};

template<>
struct std::formatter<Person> : std::formatter<string> {
    auto format(Person const& p, auto& ctx) const {
        return std::formatter<string>::format(
            std::format("Person{{id={}, name={}, age={}, female={}, address={}}}",
                        p.id, p.name, p.age,
                        p.female ? (*p.female ? "yes" : "no") : "unknown",
                        p.address ? *p.address : "none"),
            ctx);
    }
};
Huvudprogram
int main() {
    try {
        constexpr auto URL = "postgresql://orm:orm@localhost:5432/tiny_orm_test";
        auto conn = db::connect(URL);
        auto dao = db::DAO<Person>{*conn};
        dao.create();

        auto anna = Person{.name = "Anna Conda", .age = 23, .female = true,
                           .address = "17 Hacker Lane"};
        dao.insert(anna);
        auto const obj = dao.load(anna.id);
        std::println("obj: {}", *obj);
        dao.remove(anna.id);

        auto data = vector<Person>{
            {.name = "Per Silja", .age = 43, .address = "42 Cobol Blvd."},
            {.name = "Inge Vidare", .age = 53},
            {.name = "Åke R. Vidare", .age = 67, .female=false, .address="123 Perl Lane"},
            {.name = "Justin Time", .age = 37, .female = false},
            {.name = "Cata Logue", .age = 49, .female = true, .address="1 Rust Conduit"},
        };
        dao.insert_all(data);

        constexpr auto age = db::field<^^Person::age>;
        constexpr auto name = db::field<^^Person::name>;
        auto const result = dao.select()
                .where(age >= 40)
                .order_by(name)
                .all();
        auto cnt=1;
        for (auto&& p: result) std::println("{}: {}", cnt++, p);

        dao.drop();
    } catch (db::db_error const& x) {
        std::println("ERR: {}", x.what());
    } catch (...) {
        std::println("Unknown error");
    }
}
Utdata
$ /home/jensr/GitHubProjects/cxx26-tiny-orm/build/simple-psql-demo
obj: Person{id=1, name=Anna Conda, age=23, female=yes, address=17 Hacker Lane}
-- Query Result --
1: Person{id=6, name=Cata Logue, age=49, female=yes, address=1 Rust Conduit}
2: Person{id=3, name=Inge Vidare, age=53, female=unknown, address=none}
3: Person{id=2, name=Per Silja, age=43, female=unknown, address=42 Cobol Blvd.}
4: Person{id=4, name=Åke R. Vidare, age=67, female=no, address=123 Perl Lane}
Realisering av query
Låt oss följa anropskedjan för databasfrågan dao.select()...all(). Det börjar med metoden select, som
returnerar ett query-objekt.
auto const result = dao.select() .where(age >= 40) .order_by(name) .all();
//...
auto select() const -> query<T> {
    return query<T>{db_, &db_->sql_dialect()};
}
Denna klass realiserar Builder design pattern och ser i sammandrag ungefär ut så här:
template<typename T>
class query {
    connection*                 db_  = nullptr;
    dialect const*              sql_ = nullptr;
    std::optional<predicate<T>> where_{};
    std::vector<std::string>    order_{};
    std::optional<int>          limit_{};
    std::optional<int>          offset_{};
    enum class projection { columns, count_star };
    auto assemble(projection what) const -> statement {...}
    auto run(statement const& s) const -> result_set {...}
public:
    query(connection* db, dialect const* sql) : db_{db}, sql_{sql} {}
    auto where(predicate<T> p) -> query& {
        where_ = where_ ? (*where_ && p) : p; return *this;
    }
    template<std::meta::info M>
    auto order_by(field_t<M> f, sort dir = sort::asc) -> query& {...}
    auto limit(int n) -> query& {...}
    auto offset(int n) -> query& {...}
    auto all() const -> std::vector<T> {
        auto const rs = run(assemble(projection::columns));
        auto out = std::vector<T>{}; out.reserve(rs.size());
        for (auto i = 0uz; i < rs.size(); ++i) out.push_back(detail::to_entity<T>(rs, i));
        return out;
    }
    auto first() const -> std::optional<T> {...}
    auto count() const -> long {...}
};
Alla mellanliggande funktionsanrop lägger till data i de interna delarna av query, tills en terminerande
funktion såsom all, first eller count anropas, varpå databasen kontaktas och resultatet samlas ihop.
Den privata funktionen assemble sammanställer den SQL som ska utföras och skickar detta till run. Så
här ser den förstnämnda ut, i förkortad form. Den sistnämnda följer efteråt och delegerar vidare till execute
i connection-objektet.
auto assemble(projection what) const -> statement {
    auto fragment =
        std::format("SELECT {} FROM {}",
                    what == projection::count_star ? std::string{"COUNT(*)"}
                                                   : detail::column_list(columns_of<T>()),
                    detail::mark_id(table_name_of<T>().view()));
    auto params = std::vector<param>{};
    if (where_) {
        fragment += std::format(" WHERE {}", where_->sql);
        params = where_->params;
    }
    if (what == projection::columns) {
        if (!order_.empty()) {
            fragment += " ORDER BY ";
            for (auto i = 0uz; i < order_.size(); ++i) {
                if (i > 0) fragment += ", "; fragment += order_[i];
            }
        }
        if (limit_) {
            fragment += " LIMIT ?";
            params.push_back(std::format("{}", *limit_));
        }
        if (offset_) {
            fragment += " OFFSET ?";
            params.push_back(std::format("{}", *offset_));
        }
    }
    fragment += ";";
    return {detail::render(*sql_, fragment), std::move(params)};
}

auto run(statement const& s) const -> result_set {
    if (db_ == nullptr) throw db_error{"..."};
    return db_->execute(s);
}
Resultatet placeras i ett objekt av typen result_set som jag visade tidigare, via funktionen
psql_connection::to_result_set (vi håller oss till PostgreSQL för enkelhetens skull).
static auto psql_connection::to_result_set(PGresult* res) -> result_set {
    auto const fields = PQnfields(res);
    auto const tuples = PQntuples(res);
    auto       columns = std::vector<std::string>{};
    columns.reserve(static_cast<std::size_t>(fields));
    for (auto f = 0; f < fields; ++f) columns.emplace_back(PQfname(res, f));

    auto rows = std::vector<std::vector<cell>>{};
    rows.reserve(static_cast<std::size_t>(tuples));
    for (auto t = 0; t < tuples; ++t) {
        auto row = std::vector<cell>{};
        row.reserve(static_cast<std::size_t>(fields));
        for (auto f = 0; f < fields; ++f) {
            if (PQgetisnull(res, t, f) != 0) row.emplace_back();
            else row.emplace_back(PQgetvalue(res, t, f));
        }
        rows.push_back(std::move(row));
    }
    return result_set::of(std::move(columns), std::move(rows));
}

static auto result_set::of(std::vector<std::string> columns,
                           std::vector<std::vector<cell>> rows) -> result_set
{
    auto rs      = result_set{};
    rs.columns_  = std::move(columns);
    rs.rows_     = std::move(rows);
    rs.affected_ = static_cast<long>(rs.rows_.size());
    return rs;
}
Efter anropet till run samlas resultatet ihop i en std::vector på följande vis
auto out = std::vector<T>{}; out.reserve(rs.size());
for (auto i = 0uz; i < rs.size(); ++i) out.push_back(detail::to_entity<T>(rs, i));
return out;
Den intressanta delen här utgörs av anropet till detail::to_entity, vilken bygger ett entitetsobjekt baserat
på en resultat-rad (kolumn-data). Här ser vi återigen hur reflection i C++26 hjälper oss att skriva helt generisk
programkod.
template<typename T>
auto to_entity(result_set const& rs, std::size_t row) -> T {
    auto obj = T{};
    template for (constexpr auto m : members_of<T>()) {
        constexpr auto c = describe(m);
        using V = typename [: std::meta::type_of(m) :];
        obj.[: m :] = from_cell<V>(rs.at(row, c.name.view()));
    }
    return obj;
}
Här skapar vi först ett tomt objekt med dess default-konstruktor. Loopar sedan över alla medlemsvariabler, sammanställer metadata för var och en, samt gör ett reflektivt anrop genom att plocka ut aktuellt databas-resultat, dvs kolumndata, och tilldela detta värde till motsvarade medlemsvariabel. Den här kategorin av programkod var totalt omöjlig att skriva före C++26.
Från CSV till SQL och vidare till JSON
När vi nu har reflektivt insamlat metadata för en klass, så kan vi gå vidare med mer generisk kod. Vad sägs om att:
- Läsa in data i CSV format
- Reflektivt omvandla varje rad till ett entitetsobjekt
- Sätta in alla objekt i en databas, genom att reflektivt generera SQL
- Extrahera några rader från databasen, via en reflektivt skapad SQL query
- Reflektivt omvandla varje returnerad rad till ett entitetsobjekt
- Reflektivt omvandla varje objekt till ett JSON-objekt
- Skriva ut dessa som en JSON-array
CSV data
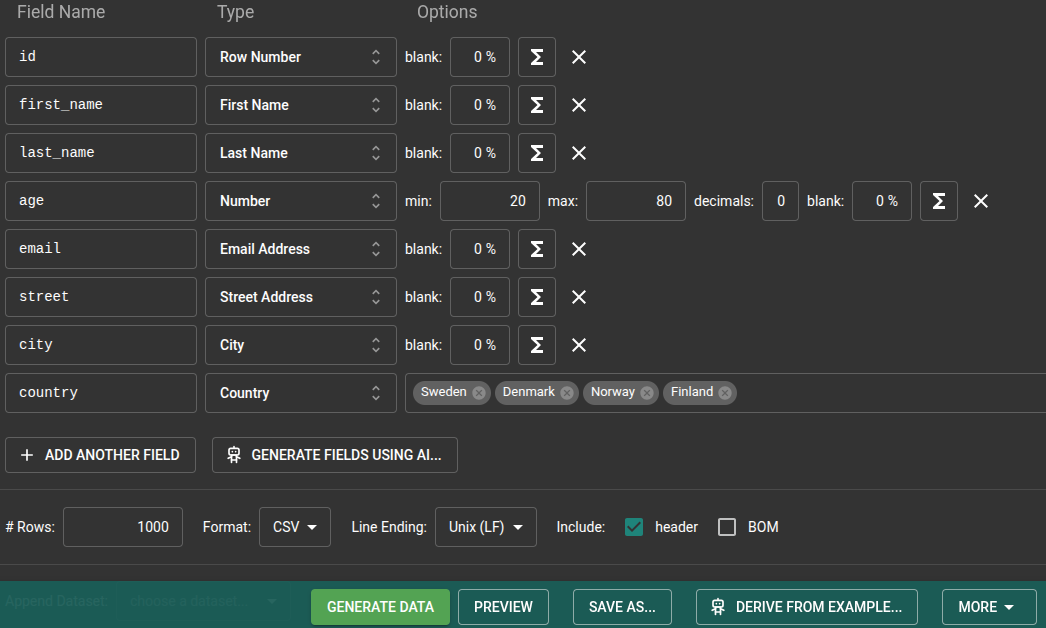
Jag började med att generera fake-data hos mockaroo.com, för person-objekt och spara som CSV (komma-separerade
data-fält). Resultatet, och indata for nästa demo-program, finns i filen data/person-data.csv.
Entitetstyp
Baserat på denna kunde jag sen skapa och dekorera en entitetstyp, där jag valt enklast tänkbara.
struct [[= db::Table{} ]] Person {
    //id,first_name,last_name,email,gender,street,city,country
    [[=db::PrimaryKey{.auto_increment = true}]]
    long id{};
    string first_name{};
    string last_name{};
    int age{};
    string email{};
    optional<string> street{};
    optional<string> city{};
    string country{};
};

template<>
struct std::formatter<Person> : std::formatter<string> {
    auto format(Person const& p, auto& ctx) const {
        return std::formatter<string>::format(
            std::format("Person(id={}, name={} {}, age={}, email={}, address={}, {}, {})",
                        p.id,
                        p.first_name, p.last_name, p.age, p.email,
                        p.street.value_or("-"), p.city.value_or("-"), p.country),
            ctx);
    }
};
Inläsning av CSV
Första delen av huvudprogrammet verifierar att datafilen finns och läser in innehållet till en std::vector
av entitetsobjekt.
auto csv_file = fs::path{argc > 2 ? argv[2] : "data/person-data.csv"};
if (not fs::exists(csv_file)) { ... }

auto csv_opts = db::csv_options{.delimiter = ',', .has_header = true};
auto lines    = db::read_csv_file<Person>(csv_file, csv_opts);
std::println("read {} lines from {}", lines.size(), csv_file);

auto const N = 5;
std::println("-- first {} Person objects --", N);
for (auto cnt = 1; auto&& p: lines | std::views::take(N))
    std::println("{}) {}", cnt++, p);
Funktionen read_csv_file ovan utför hela jobbet och i grova drag ser det ut på följande vis:
auto lines    = db::read_csv_file<Person>(csv_file, csv_opts);
//...
template<typename T>
auto read_csv_file(std::filesystem::path const& path, csv_options opt = {}) -> std::vector<T> {
    auto in = std::ifstream{path}; if (!in) throw csv_error{"..."};
    return read_csv<T>(in, opt);
}
//...
template<typename T>
auto read_csv(std::istream& in, csv_options opt = {}) -> std::vector<T> {
    auto rows = std::vector<T>{};
    for_each_csv<T>(in, [&rows](T&& row) { rows.push_back(std::move(row)); }, opt);
    return rows;
}
//...
template<typename T, typename Fn>
void for_each_csv(std::istream& in, Fn&& fn, csv_options opt = {}) {
    auto fields = std::vector<std::string>{};
    auto header = std::vector<std::string>{};

    if (opt.has_header) {
        if (!detail::read_record(in, opt, fields)) return; // empty input
        header = fields;
    }
    auto const indices = detail::field_indices<T>(header, opt);

    auto record = 0L;
    while (detail::read_record(in, opt, fields)) {
        ++record;
        if (fields.size() == 1 && fields[0].empty()) continue; // blank line
        fn(detail::to_row<T>(fields, indices, opt, record));
    }
}
Funktionen read_record tar hand om själva CSV-parsningen, genom att läsa tecken för tecken och populera en
vektor av textsträngar (fields) med extraherat data. Funktionen field_indices sammanställer reflektivt
index för en rad, vilket används senare för att plocka ut respektive dataelement. Funktionen to_row tar både
fields och indices, samt reflektivt skapar och returnerar ett entitetsobjekt.
Insättning i databas
Nästa steg är att sätta in alla tusen objekt i databasen. Detta har jag redan förklarat hur det går till tidigare i denna artikel, utan visar därför bara programkoden. Notera användningen av ett litet RAII-objekt för att säkerställa att databasen töms helt i samband med att programmet avslutas.
constexpr auto URL = "postgresql://orm:orm@localhost:5432/tiny_orm_test";
auto conn  = db::connect(URL);
auto dao   = db::DAO<Person>{*conn};
auto guard = scope_exit{[&] noexcept { try { dao.drop(); } catch (...) {} }};
dao.create();
dao.insert_all(lines);
//...
template<typename F>
struct scope_exit { F fn; ~scope_exit() { fn(); } };
Enkel query
När väl all data finns på plats i databasen kan vi bygga en query för att få några objekt att skriva ut. Så här ser den koden ut.
constexpr auto age     = db::field<^^Person::age>;
constexpr auto country = db::field<^^Person::country>;
auto result = dao.select()
        .where(age == 20)
        .where(country == "Denmark")
        .order_by(country)
        .all();
Från objekt till JSON
I sista steget har jag valt att använd Nils Lohmans eminenta bibliotek för JSON-hantering. Den plockas ned automatiskt av CMake i samband med bygget av projektet. Jag skapar en JSON-array, loopar över alla person-objekt, gör om var och en till ett motsvarande JSON-objekt och adderar till array:en. Slutligen skrivs denna ut - pretty-print:ad.
auto json = nlohmann::json::array();
for (auto&& p: result) json.push_back(as_json(p));
std::println("{}", json.dump(2));
Det intressant här ovan är givetvis funktionen as_json. Den gör samma reflektiva loop som vi har sett flera gånger
tidigare.
template<typename>
inline constexpr auto is_optional = false;
template<typename T>
inline constexpr auto is_optional<std::optional<T>> = true;

template<typename T>
static auto as_json(T const& e) -> nlohmann::json {
    auto j = nlohmann::json::object();
    template for (constexpr auto m: db::detail::members_of<T>()) {
        auto const& v = e.[: m :]; //get value of property m of e
        auto key      = std::string{std::meta::identifier_of(m)};
        if constexpr (is_optional<std::remove_cvref_t<decltype(v)>>)
            j[key] = v ? nlohmann::json(*v) : nlohmann::json(nullptr);
        else
            j[key] = v;
    }
    return j;
}
Kom ihåg från förra artikeln att en template for loop, rullas ut av kompilator, och i varje genererat kodblock
läses property-value och property-name, samt en tilldelning till aktuellt JSON-objekt. Om värdet var en std::optional
hämtas det inneslutna värdet ut, om det finns något.
Utskrift
När vi kör programmet, kan det se ut så här:
$ /build/simple-csv-to-psql-demo
read 1000 lines from data/person-data.csv
-- first 5 Person objects --
1) Person(id=1, name=Andy Mann, age=68, email=amann0@rediff.com, address=7 Quincy Street, Juuka, Finland)
2) Person(id=2, name=Ardisj Tellenbroker, age=75, email=atellenbroker1@sun.com, address=6 Independence Point, Mo I Rana, Norway)
3) Person(id=3, name=Sheree Basant, age=20, email=sbasant2@gravatar.com, address=7 Jackson Place, Luleå, Sweden)
4) Person(id=4, name=Sutherland Bess, age=78, email=sbess3@bloglines.com, address=62 Bartelt Crossing, Tampere, Finland)
5) Person(id=5, name=Elvera Waltho, age=66, email=ewaltho4@ask.com, address=4 South Place, Knivsta, Sweden)
-- query result: age 20 living in Denmark, as JSON --
[
  {
    "age": 20,
    "city": "København",
    "country": "Denmark",
    "email": "abrevittd@telegraph.co.uk",
    "first_name": "Andras",
    "id": 14,
    "last_name": "Brevitt",
    "street": "18509 Melvin Trail"
  },
  {
    "age": 20,
    "city": "København",
    "country": "Denmark",
    "email": "schallonerjh@gravatar.com",
    "first_name": "Sanson",
    "id": 702,
    "last_name": "Challoner",
    "street": "58 Sunnyside Hill"
  }
]
OpenFlights demo
Projektet innehåller också ett demo-program som sammanställer flygrelaterade data, från OpenFlights. Eftersom copyright inte tillåter vidaredistribution, så finns det ett skript som laddar ned all data.
  read  airports.dat     7698 rows    151 ms
  read  routes.dat      67663 rows    534 ms

  load  airports         7698 rows    180 ms
  skip                   1347 routes with dangling references (2.0%)
  load  routes          66316 rows   1105 ms

tables: 7698 airports, 6162 airlines, 246 planes, 66316 routes
Hur du bygger och kör demon själv
Här nedan beskriver jag all steg för att kunna bygga och köra demo-programmen.
Kompilator
Kompilatorn måste klara C++26 Reflection, eftersom det är ju vad detta går ut på.
För egen del har jag laddat ned källkoden till GCC, byggt och installerat resultatet
till /opt/gcc-16/*. Beroende på när du läser detta så får du eventuellt göra sammalunda.
Externa bibliotek
Båda databasdrivrutinerna måste installeras med ditt systems pakethanterare. Om någon saknas, kommer CMake tala om detta, samt hoppa över den kod som är beroende av denna.
# Debian / Ubuntu
sudo apt install libpq-dev libsqlite3-dev

# Fedora / RHEL
sudo yum install libpq-devel sqlite-devel

# Alpine
sudo apk add libpq-dev sqlite-dev
De övriga två biblioteken, Catch2 för testning och nlohman::json för JSON-rendering
hämtas däremot av CMake under bygget. Så det är ingenting extra du behöver göra.
Clon:a repo:n
Projekt-koden ligger på GitHub:
$ cd some/path/
$ git clone https://github.com/ribomation/cxx26-tiny-orm.git
$ cd cxx26-tiny-orm
PostgreSQL via Docker
Vill du köra mot en PostgreSQL database — och det vill du ju — så behöver
du ha Docker installerad. I docker/-katalogen hittar du ett skript du ska köra för
att starta upp en psql container.
$ docker compose -f docker/docker-compose.yml up -d
$ docker compose -f docker/docker-compose.yml ps
NAME          IMAGE                ...   STATUS                PORTS
tiny-orm-db   postgres:18-alpine   ...   Up 4 days (healthy)   0.0.0.0:5432->5432/tcp
OpenFlights
Vill du köra open-flights demon, så behöver du först ladda ned datafilerna.
$ ./scripts/fetch-openflights.sh
OpenFlights data -> /home/jensr/GitHubProjects/cxx26-tiny-orm/data/openflights
  airports      7698 rows   1127225 bytes
  airlines      6162 rows    396896 bytes
  routes       67663 rows   2377148 bytes
  planes         246 rows      8331 bytes
  countries      261 rows      5989 bytes
Byggnation med CMake
Du bygger hela projektet med standard cmake kommandon
$ cmake -S . -B build -DCMAKE_CXX_COMPILER=/opt/gcc-16/bin/g++
$ cmake --build build -j 8
-- tiny-orm: libpq 18.6 found -- PostgreSQL backend enabled.
-- tiny-orm: SQLite 3.46.1 found -- SQLite backend enabled.
$
$ ctest --test-dir build
100% tests passed, 0 tests failed out of 88

Total Test time (real) =   3.04 sec
Demo-program
Efter bygget har du följande demo-program tillgängliga i ./build/
sql-generation-exampleopenflights-appsimple-account-demosimple-psql-demosimple-csv-to-psql-demotiny-orm-unit-teststiny-orm-integration-tests
Kör du openflights demon, kan du välja om databasen ska vara psql eller sqlite.
./build/openflights-app                          # PostgreSQL, enligt compose-filen
./build/openflights-app "sqlite::memory:"        # ingen server behövs
./build/openflights-app "sqlite:/tmp/flights.db" # eller en fil
connected to sqlite::memory: (sqlite)
schema created from the structs
read airports.dat 7698 rows 151 ms
read airlines.dat 6162 rows 54 ms
read planes.dat 246 rows 1 ms
read routes.dat 67663 rows 534 ms
load airports 7698 rows 180 ms
load airlines 6162 rows 72 ms
load planes 246 rows 1 ms
skip 1347 routes with dangling references (2.0%)
load routes 66316 rows 1105 ms
tables: 7698 airports, 6162 airlines, 246 planes, 66316 routes
Busiest airports by departing routes
Hartsfield Jackson Atlanta International Airport United States 915 routes to 217 airports
Chicago O'Hare International Airport United States 558 routes to 206 airports
Beijing Capital International Airport China 531 routes to 204 airports
London Heathrow Airport United Kingdom 525 routes to 170 airports
Airlines by route count
Ryanair Ireland 2484
American Airlines United States 2352
United Airlines United States 2178
Highest airports, via the typed query builder
Daocheng Yading Airport China 14472 ft
Qamdo Bangda Airport China 14219 ft
Kangding Airport China 14042 ftSammanfattning
När jag 2003 kastade EJB på skräphögen till förmån för Hibernate, var det reflektion i runtime som gjorde magin möjlig. Drygt tjugo år senare kan vi göra samma sak i C++ — fast i compile-time. Med annoteringar på en vanlig struct härleder ramverket tabellnamn, kolumner, SQL-typer och primärnyckel, och genererar både DDL, CRUD-satser och typade queries för olika SQL-dialekter.
Den största överraskningen var inte reflektionen i sig, utan att text måste kunna existera som konstanter.
Lösningen blev compiletime_string ihop med std::define_static_string. I övrigt är det samma mönster som
återkommer överallt: en template for-loop över medlemmarna, som kompilatorn rullar ut till helt vanlig kod.
Samma teknik som bygger ett objekt från en databasrad, bygger det också från en CSV-rad eller omvandlar det
till JSON — kod som helt enkelt inte gick att skriva generiskt före C++26.
Tiny-ORM är förstås ingen ersättare för Hibernate, men med stöd för PostgreSQL och SQLite, ett DAO, en query-builder och 88 gröna tester, visar den att ett riktigt ORM-ramverk i ren C++ inte längre är en utopi. Hela koden finns på GitHub — klona, bygg och experimentera själv.
Länkar
Senaste Artiklarna
-
Väderdata med Boost
15 oktober 2026 -
Kom igång med Boost
2 oktober 2026 -
C++26 ORM via Reflection
29 september 2026 -
C++26 Reflection
18 september 2026 -
C++26 Contracts
11 september 2026 -
Cargo – konvention framför konfiguration
4 september 2026 -
Referenser & pekare i Rust jämfört med C++
28 augusti 2026 -
När Rust får panik gör C++ ett undantag
21 augusti 2026