
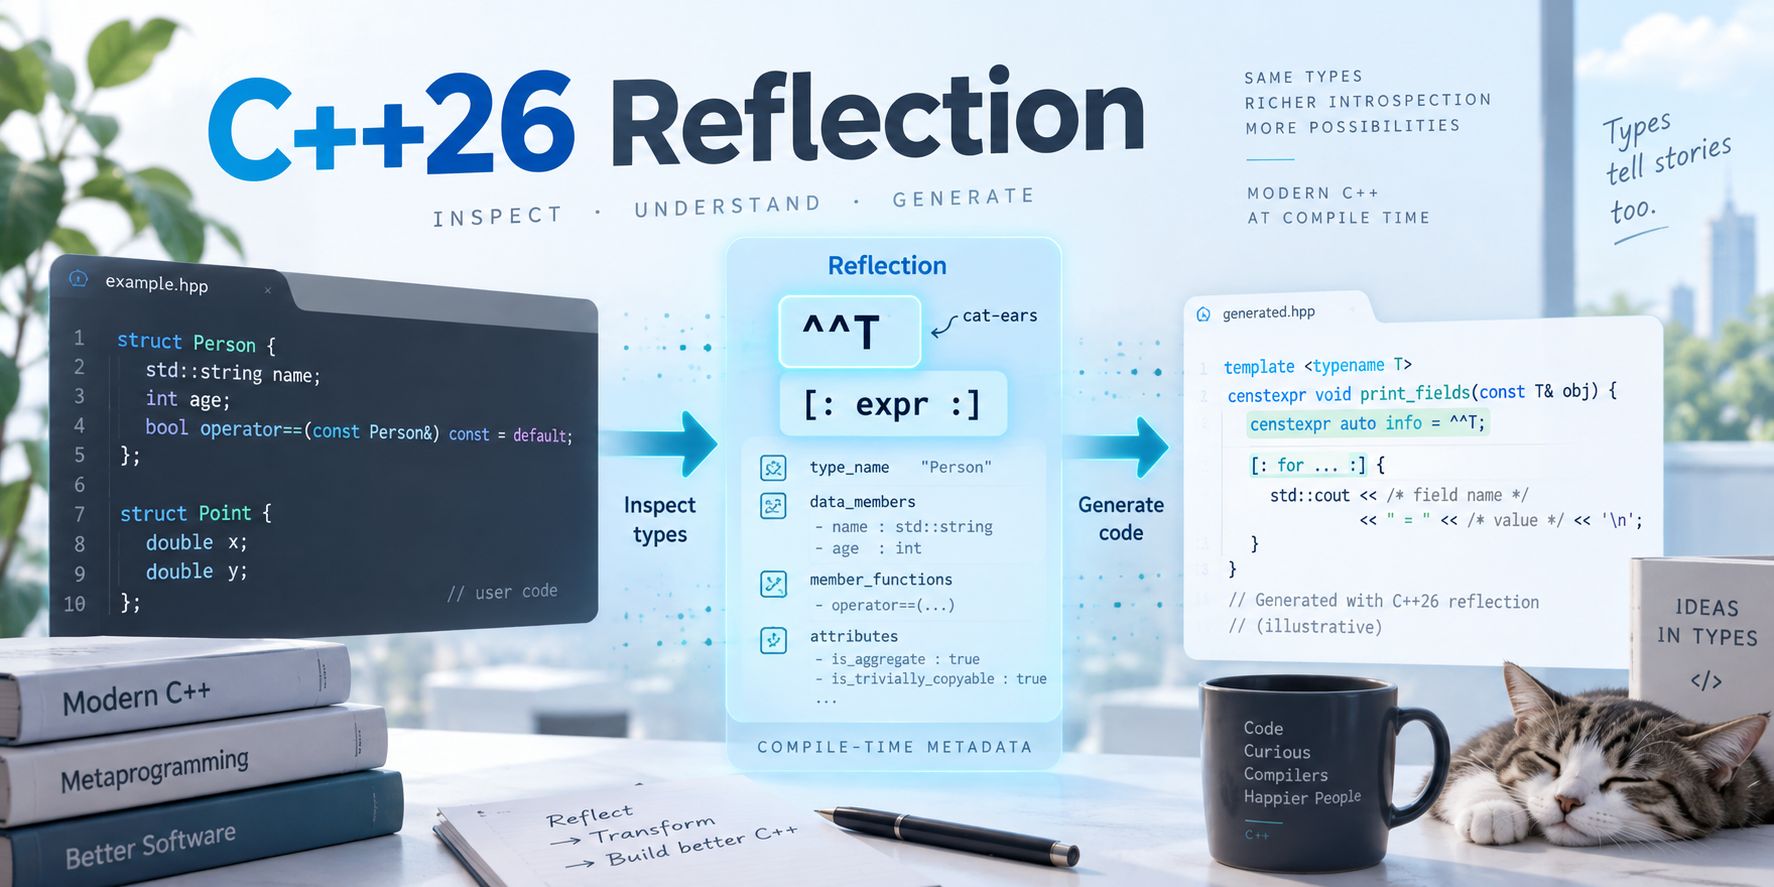
Hur många gånger har du skrivit samma to_string() en gång till? Samma fem rader, samma
fältnamn utskrivna för hand, samma risk att glömma det fält någon la till förra veckan.
Kompilatorn vet redan allt som behövs — den har hela typen framför sig — men
fram till nu har den inte velat berätta. I C++26 gör den det.
Reflection i C++ är dock inte det du känner igen från Java eller C#. Där är det en service
som utförs medan programmet exekverar, med metadata i binären och uppslagning via strängar. I
C++26 är en reflektion ett constexpr-värde som skapas och konsumeras under
kompileringen, och som inte finns kvar efteråt. Java frågar "hur ser det här objektet ut
just nu?"; C++ frågar "hur ser den här typen ut, så att jag kan skriva kod åt den?". Det är
inte en runtime-tjänst — det är en kodgenerator som bor i kompilatorn.
I den här artikeln går jag igenom de fyra nya syntaxelementen — ^^ som reflekterar,
[: :] som splicar tillbaka, template for som rullar ut en loop vid kompilering, och
[[= ]] som hänger metadata på en deklaration — samt std::meta::info, värdet som
allt kretsar kring. Sedan bygger vi en generisk stringify() på 25 rader som renderar
vilken struct som helst utan en enda rad skriven per typ, och använder samma splice för att
skriva till fälten också. Därefter tar vi isär vad template for faktiskt kompilerar till,
rad för rad, och konstaterar att det som återstår vid körning är precis den kod du hade
skrivit för hand — en poäng som demokoden kontrollerar åt oss genom att jämföra tre
gradvis expanderade varianter. Vi tittar också på vad GCC 16.1 vill ha för flaggor och
vilket felmeddelande du får när du glömmer dem. Allt är byggt och kört på riktigt, och ligger
på GitHub.
Nästa vecka tar vi annotationerna på allvar och bygger vidare på det här: en liten ORM som
härleder CREATE TABLE, INSERT, UPDATE, DELETE, SELECT ur vanliga structar, utan makron
och utan kodgenerator.
Vad är reflection?
Reflection är ett programs förmåga att undersöka sin egen struktur. Typer, medlemmar, funktioner, namnrymder — sådant som normalt bara finns som syntax i källkoden blir istället tillgängligt som data, som programmet kan ställa frågor om.
Det brukar delas i två halvor:
- Introspection — att fråga "hur ser den här typen ut?" och få ett svar man kan agera på. Vilka fält finns? Vad heter de? Vilka typer har de?
- Generation — att göra något med svaret. Bygga en serializer, en
enum-till-sträng-funktion, en databindning, en kommandoradsparser.
Det är den andra halvan som gör det intressant. Introspection ensamt är en kuriositet; det är när svaret får bli till ny kod som man slipper skriva samma sak en gång per typ.
Och det är just "en gång per typ" som är problemet reflection löser. Alla som har skrivit
en to_string(), en JSON-serializer eller en operator<< för ett par dussin structar vet
hur det ser ut: samma fem rader, om och om igen, med fältnamnen utbytta. Kompilatorn vet
redan allt som behövs — den har hela typen framför sig — men fram till nu har
den inte velat berätta.
Helt nytt är det inte för C++. Vi har <type_traits>, som kan svara på en del frågor
(is_pointer_v, is_aggregate_v, ...), och vi har makron, som kan generera kod. Men
<type_traits> kan bara svara på de frågor någon har skrivit ett trait för, och makron
vet ingenting om typer alls — de klipper och klistrar text. Kombinationen har
approximerat reflection i tjugo år, med varierande grad av elegans.
C++26 gör det till en riktig språkfunktion.
Reflection i andra språk
Innan vi tittar på C++-varianten är det värt att veta vad ordet betyder för alla andra, eftersom C++ menar något ganska annorlunda med det.
Java och C# har det man brukar tänka på när man hör "reflection". Ett Class<?>- eller
Type-objekt finns tillgängligt vid körning, med metoder som getMethods() och
getFields(). Man kan inspektera ett levande objekt, plocka ut ett fält man inte visste
namnet på förrän i runtime, anropa en metod via en sträng, och i vissa fall ändra saker som
källkoden inte ens visste fanns. Det är kraftfullt, det är grunden för hela ramverk som
Spring och Hibernate — och det kostar. Metadata följer med in i den körbara artefakten,
uppslagningen sker vid körning, och JIT-kompilatorn får svårare att optimera.
Python har inte reflection som en påbyggnad. Det är språket. dir(), getattr(),
__dict__ — allt är slagbart, alltid, och ett objekt kan få nya attribut medan
programmet kör. Frågan "vad kostar det?" är irrelevant, eftersom allting redan kostar.
Rust har ingen generell reflection alls. Det man använder istället är derive- och
procedurmakron, som kör vid kompilering och genererar kod — men de arbetar på
syntax, på en token-ström, inte på en typmodell man kan ställa frågor till. Ett
proc-makro som ser struct Account { iban: IBAN } vet att det står IBAN där; det vet
inte att IBAN står för International Bank Account Number och hur ett dylikt objekt
ska hanteras.
Det speciella med C++-varianten
C++26 passar inte in i något av de facken. Reflection i C++ är enbart en compile-time-företeelse.
En reflektion är ett constexpr-värde av typen std::meta::info. Det skapas vid
kompilering, konsumeras vid kompilering, och finns inte kvar efteråt. Det finns inga
typobjekt att slå upp vid körning, ingen metadatatabell i binären, ingen uppslagning via
sträng. Inget hamnar i den körbara filen utom exakt det du explicit har genererat.
Skillnaden är lättast att se i vilken fråga språken ställer:
Java och C# frågar: "hur ser det här objektet ut just nu?"
C++ frågar: "hur ser den här typen ut, så att jag kan skriva kod åt den?"
Det är samma ord för två rätt olika saker. Java-varianten är en service som programmet anropar. C++-varianten är en kodgenerator som körs i kompilatorn.
Det ligger helt i linje med hur C++ brukar resonera. Zero-overhead-principen säger att man inte ska betala för det man inte använder, och att det man använder inte ska gå att skriva bättre för hand. Reflection i C++26 uppfyller båda: använder du det inte kostar det noll, och använder du det får du exakt den kod du hade skrivit själv — för det är den kod du hade skrivit själv, bara utstansad av kompilatorn istället för av dig.
Priset för det är att allt som kräver dynamik är uteslutet. Du kan inte ladda in en plugin och fråga vad den innehåller, inte slå upp ett fält utifrån en sträng som kommer från en konfigurationsfil, inte bygga något i stil med Spring Framework/Boot. Det är inte en brist som ska fixas senare — det är designen. Vill du ha den sortens dynamik får du fortsatt bygga den själv, ovanpå den statiska modellen.
Fyra nya syntaxelement
Reflection kommer med fyra nya bitar syntax. De är ovanliga att se på, men det är bara fyra — och de hänger ihop parvis.
| Syntax | Namn | Gör |
|---|---|---|
^^T |
reflektionsoperatorn | entitet → std::meta::info |
[: r :] |
splice-operatorn | std::meta::info → entitet |
template for |
expansion statement | loop som rullas ut vid kompilering |
[[= expr ]] |
annotation | fäster metadata på en deklaration |
Reflektionsoperatorn ^^
^^ — av uppenbara skäl kallad cat ears — är vägen in. Den appliceras på i
princip vilken entitet som helst: en typ, en variabel, en funktion, ett enum-värde, en
namnrymd, en template.
constexpr auto r1 = ^^int;              // en typ
constexpr auto r2 = ^^std::string;      // också en typ
constexpr auto r3 = ^^twice;            // en funktion
constexpr auto r4 = ^^schema;           // en namnrymd
constexpr auto r5 = ^^schema::Account;  // en typ inuti namnrymden
Resultatet är alltid detsamma: ett objekt av typen std::meta::info. Det är avsiktligt.
Alla entiteter, oavsett vad de är, blir värden av en och samma typ — vilket är precis vad
som krävs för att kunna lägga dem i en std::vector och loopa över dem.
std::meta::info — valutan
std::meta::info är ogenomskinlig i sig själv. Allt intressant sker i de funktioner som
tar emot den. De kommer i två familjer.
Extraktorer, som plockar isär en entitet och ger nya info-värden tillbaka:
members_of(r, ctx)                // alla medlemmar i en klass
nonstatic_data_members_of(r, ctx) // bara de icke-statiska datafälten
bases_of(r, ctx)                  // basklasserna
enumerators_of(r)                 // enum-medlemmarna och deras värden
type_of(r)                        // typen hos en medlem eller variabel
identifier_of(r)                  // namnet, som en sträng
annotations_of(r) // annotationerna (mer om dem i nästa artikel)Predikat, som svarar ja eller nej:
is_type(r)          is_variable(r)       is_function(r)
is_constructor(r)   is_public(r)         is_const(r)
…och en bra bit fler i båda familjerna. Poängen är att info både går in och kommer ut:
type_of(m) på en medlem ger dig en info som beskriver medlemmens typ, som du i sin tur
kan ställa nya frågor om. Det är en typmodell man kan navigera i, inte en platt lista.
access_context-argumentet (ctxovan) är C++ som är sig likt: åtkomstregler gäller även här. En reflektion tagen utifrån klassen ser inte dess privata medlemmar. Man skapar kontexten medstd::meta::access_context::current(), och får då exakt den åtkomst den omgivande koden har.
Splice-operatorn [: :]
Splicen är motsatsen till ^^. Där ^^T gör om en entitet i programmet till ett värde,
gör en splice om värdet tillbaka till en entitet som kompilatorn agerar på.
Det är den halvan som gör det hela användbart. Att veta att Point3D har ett fält som
heter x är trevligt; att kunna skriva p.x utan att ha skrivit bokstäverna x är
poängen.
Splicen har fyra former, beroende på vad info-värdet betecknar:
[: r :]                 // en variabel, en funktion, ett enum-värde, ...
typename [: r :]        // en typ
template [: r :]        // ett template-namn
obj.[: r :]             // ett icke-statiskt fält i objektet obj
Expansion statement: template for
template for är en loop som körs i kompilatorn. Den itererar över en sekvens som är känd
vid kompilering — en std::define_static_array() av info-värden, en std::tuple<T,...>, en
constexpr range — och istället för att generera en loop i den färdiga koden rullar
den ut kroppen, en kopia per element.
Det låter som en optimering, men det är en språkfunktion, och skillnaden är viktig: i varje
utrullad kopia är loopvariabeln en konstant, och den kan ha olika typ i olika varv.
Det är det som ingen vanlig for klarar, och skälet till att det behövdes en ny sats och
inte bara ett bibliotekstrick.
Annotationer [[= ]]
Den fjärde biten nämner jag bara i förbigående här, för den är hela ämnet för nästa
artikel. Med [[= uttryck ]] hänger man ett godtyckligt constexpr-värde på en
deklaration, och annotations_of läser tillbaka det. Metadata i koden, läsbar av koden.
Exempel: stringify(obj)
Nog med syntax. Här är en generisk stringify() som renderar vilken aggregat-struct som
helst — utan en rad skriven per typ.
Först två helt vanliga structar, utan något speciellt alls:
struct Point3D {
    double x = 0.0;
    double y = 0.0;
    double z = 0.0;
};

struct Employee {
    std::string name;
    int         age;
    double      salary;
};
Och så funktionen:
template<typename TargetType>
auto stringify(TargetType const& obj) -> std::string {
    static constexpr auto ctx     = access_context::current();
    static constexpr auto members = define_static_array( nonstatic_data_members_of(^^TargetType, ctx) );
    std::string result{};
    string_view typeName = identifier_of(^^TargetType);

    result += typeName + " {"s;
    template for (bool first=true; constexpr auto m : members) {
        string_view name  = identifier_of(m);
        string_view type  = display_string_of( type_of(m) );
        auto value        = obj.[: m :];

        if (first) first=false; else result += ", ";
        if (type.starts_with("std::__cxx11::basic_string"sv)) {
            type = "std::string"sv;
            result += format("{}:{} = \"{}\"", name, type, value);
        } else {
            result += format("{}:{} = {}", name, type, value);
        }
    }
    result += "}";

    return result;
}
Rad för rad, i den ordning det händer:
^^TargetTypereflekterar mallparametern. Vi vet inte vilken typ det är — men kompilatorn gör det, vid varje instansiering.nonstatic_data_members_of(..., ctx)ger tillbaka enstd::vector<std::meta::info>, ett element per datafält.define_static_array(...)flyttar upp den vektorn i statisk lagring. Det behövs eftersom vektorn är en temporär under kompileringen, ochtemplate forbehöver en sekvens som lever kvar. Resultatet är enstd::spanin i en array som kompilatorn har materialiserat.identifier_of(^^TargetType)ger typens namn som sträng. Där försvann behovet av att hårdkoda"Point3D"någonstans.template for (...)rullar ut kroppen, en gång per fält.identifier_of(m)ger fältets namn,display_string_of(type_of(m))dess typ.obj.[: m :]splicar in medlemmen som en faktisk fältåtkomst. Det här är hela grejen. I det första varvet är det uttrycketobj.x; i det andraobj.y.
Anropet ser ut som vilket funktionsanrop som helst:
auto p = Point3D{1, 2.5, -3};
std::println("p: {}", stringify(p));

auto e = Employee{"Nisse", 42, 12345.0};
std::println("e: {}", stringify(e));
p: Point3D {x:double = 1, y:double = 2.5, z:double = -3}
e: Employee {name:std::string = "Nisse", age:int = 42, salary:double = 12345}Notera att Employee innehåller en std::string och Point3D tre double, och att
stringify inte vet något om vare sig det ena eller det andra. Det är samma 25 rader kod
för båda.
Den lilla
starts_with-fulheten mitt i funktionen förtjänar en förklaring.display_string_of(type_of(m))på ettstd::string-fält ger inte"std::string"— det ger"std::__cxx11::basic_string<char, std::char_traits<char>, std::allocator<char> >", eftersom det är vad typen faktiskt heter i libstdc++. Det är helt korrekt och helt oanvändbart i en utskrift, så jag städar bort det. En riktig implementation skulle jämföra mot^^std::stringistället för att matcha på sträng — men den här varianten visar bättre vad kompilatorn egentligen lämnar ifrån sig.
Samma sak, fast åt andra hållet
En splice är ett uttryck som betecknar medlemmen, inte en kopia av dess värde. Alltså går den att skriva till:
auto p = Point3D{5, 7.5, -3.25};

static constexpr auto ctx     = access_context::current();
static constexpr auto members = define_static_array( nonstatic_data_members_of(^^Point3D, ctx) );

template for (auto k = 2U; constexpr auto m: members) {
    p.[: m :] *= k++ * 10;
}
[before] Point3D {x:double = 5, y:double = 7.5, z:double = -3.25}
[after] Point3D {x:double = 100, y:double = 225, z:double = -130}Lägg märke till auto k = 2U i loopens init-del. Den variabeln deklareras en gång,
utanför kopiorna, och är en helt vanlig körtidsvariabel som alla utrullade block delar. Det
är därför k++ räknar upp genom expansionen: 2, 3, 4 — vilket ger faktorerna 20, 30
och 40.
Vad händer egentligen?
Det här är den bit som är värd att verkligen stanna upp vid, för när den väl har lagt sig på plats är resten mest detaljer.
template for gör en enda sak: kompilatorn tar loopkroppen och stansar ut en kopia per
element i sekvensen, och substituerar in elementet som en konstant i varje kopia.
template for (constexpr auto m : members) { p.[: m :] *= 10; }blir, för Point3D:
{ p.x *= 10; }
{ p.y *= 10; }
{ p.z *= 10; }
Och stringify-kroppen, för Employee, blir den expanderade koden ungefär på följande vis:
bool first = true;
string_view typeName = "Employee"sv;
string result = typeName + " {"s;
{
    // ---- Employee::name  (std::string) ----
    string_view name  = "name";
    string_view type  = "std::string";
    std::string value = obj.name;

    if (first) first = false; else result += ", ";
    result += format("{}:{} = \"{}\"", name, type, value);
}
{
    // ---- Employee::age  (int) ----
    string_view name  = "age";
    string_view type  = "int";
    int         value = obj.age;

    if (first) first = false; else result += ", ";
    result += format("{}:{} = {}", name, type, value);
}
{
    // ---- Employee::salary  (double) ----
    string_view name  = "salary";
    string_view type  = "double";
    double      value = obj.salary;

    if (first) first = false; else result += ", ";
    result += format("{}:{} = {}", name, type, value);
}
Titta på value. I första blocket är den en std::string, i andra en int, i tredje en
double — trots att källkoden bara innehåller ett enda auto value. Det är den
egenskapen som gör template for till en ny sats istället för ett bibliotekstrick: varje
kopia är sin egen kontext, med sina egna typer.
Titta sedan på if (first). Den finns kvar, i alla tre blocken, som ett vanligt körtidstest.
first deklarerades i loopens init-del, alltså en gång utanför kopiorna. Kompilatorn
rullar ut kroppen — den räknar inte ut vad koden gör. (Att optimeraren sedan ser att
first är sant i första blocket och falskt i de andra, och slänger testerna, är en helt
annan sak. Det är konstantfoldning, inte expansion.)
Och när expansionen är klar är resultatet helt vanlig C++. De tre blocken kompileras
till vanliga maskininstruktioner, hamnar i textsegmentet, och körs som all annan kod. Det
finns ingen std::meta::info kvar i binären. Det finns ingen metadatatabell, inget
uppslagsregister, ingenting att slå upp. Bara de instruktioner du hade fått om du hade
skrivit de tre blocken själv. Den kod som blir kvar ser väl ut ungefär som denna:
string result{"Employee {"};
result += format("{}:{} = \"{}\"", "name", "std::string", obj.name);
result += ", ";
result += format("{}:{} = {}"    , "age", "int", obj.age);
result += ", ";
result += format("{}:{} = {}"    , "salary", "double", obj.salary);
result += "}";
Att det verkligen är så behöver man inte ta mitt ord på. I demokoden ligger
stringify-expansion.cxx, där den reflektivastringify()och den handskrivna expansionen ovan körs sida vid sida på samma objekt, tillsammans med den reducerade versionen, och programmet jämför resultaten och returnerar felkod om de skiljer sig åt. Det gör de inte.
auto e = Employee{"Nisse", 42, 12345.0};

auto reflective = stringify(e);
auto unrolled   = stringify_unrolled(e);
auto reduced    = stringify_unrolled_reduced(e);
auto identical  = (reflective == unrolled) && (unrolled == reduced);

std::println("template for : {}", reflective);
std::println("hand-expanded: {}", unrolled);
std::println("hand-reduced : {}", reduced);
std::println("identical    : {}", identical);
template for : Employee {name:std::string = "Nisse", age:int = 42, salary:double = 12345}
hand-expanded: Employee {name:std::string = "Nisse", age:int = 42, salary:double = 12345}
hand-reduced : Employee {name:std::string = "Nisse", age:int = 42, salary:double = 12345}
identical : trueAtt kompilera det här
Stödet är i skrivande stund (september 2026) fortfarande experimentellt, men fullt användbart i GCC 16.1. Det ligger bakom en flagga:
g++ -std=c++26 -Wall -freflection my-demo.cxx -o my-demoGlömmer du -freflection är GCC vänlig nog att säga det rakt ut, om felet råkar bli en
^^-operator: "reflection is only available with -freflection". Slår det till på en
using std::meta::... högst upp i filen istället får du det betydligt trubbigare
"std::meta has not been declared", upprepat en gång per rad — vilket ser ut som
att headern saknas, men inte gör det.
std::meta bor i headern <meta>. Namnen är långa nog att det lönar sig att plocka in dem
med using-deklarationer högst upp i filen, snarare än att skriva ut std::meta:: framför
varje anrop:
#include <meta>

using std::meta::identifier_of;
using std::meta::nonstatic_data_members_of;
using std::meta::display_string_of;
using std::meta::type_of;
using std::meta::access_context;
using std::define_static_array;
All kod i artikeln är byggd och körd på riktigt, med GCC 16.1, och ligger på GitHub — klona och kör.
Nästa vecka: från reflection till ORM
Den fjärde syntaxbiten, annotationerna, har fått gå i förbigående hittills. Det är för att den förtjänar en egen artikel.
Så här ser målet ut. En helt vanlig struct, med metadata påhängd:
namespace schema {
    struct [[=Table{}]] Account {
        [[=Column{.nullable = false}]]
        [[=PrimaryKey{.auto_increment = true}]]
        int id = 0;

        [[=Column{.nullable = false}]]
        std::string customerName;

        [[=Column{.sql_type = "CHAR(34)", .nullable = false}]]
        std::string iban;

        [[=Column{.sql_type = "DECIMAL(12,2)", .default_value = "0.00"}]]
        double balance = 0.0;
    };
}
Och så här ser det ut när programmet kör:
CREATE TABLE accounts (
    id INTEGER GENERATED ALWAYS AS IDENTITY NOT NULL,
    customer_name VARCHAR(256) NOT NULL,
    iban CHAR(34) NOT NULL,
    balance DECIMAL(12,2) DEFAULT 0.00,
    PRIMARY KEY (id)
);
Inga makron. Ingen kodgenerator som körs som ett separat steg. Ingen registrering av typer i
någon förteckning. Tabellnamnet accounts och kolumnnamnet customer_name stod aldrig
skrivna någonstans — de härleddes ur Account och customerName vid kompilering, och
annotationerna säger bara det som avviker från konventionen.
Samtliga programexempel i demokoden, såsom stringify.cxx och sql-generator.cxx, finns
redan på GitHub om du vill tjuvkika. Länken finner du sist i denna artikel.
I den artikeln går jag igenom implementation av ett hyfsat komplett ORM-ramverk kallat tiny-orm. Du får se hur samma annoterade struct används både för att läsa CSV-data och generera SQL. Det sistnämnda innebär både att skapa/radera tabeller (CREATE/DROP TABLE), modifiera data (INSERT/UPDATE/DELETE), samt extrahera och aggregera data (SELECT).
Vi går igenom hur annotationer definieras och läses tillbaka, hur man härleder snake_case-namn
i consteval-kod, varför const char* och std::string_view inte överlever resan genom
reflection, och hur en felaktig foreign key blir ett kompileringsfel istället för ett runtime-problem.
Missa inte nästa veckas fortsättning då jag visar hur långt det går att dra innan man har en hel liten ORM i modern C++. "Släng dig i väggen Hibernate" 😃
Länkar
Senaste Artiklarna
-
C++26 Reflection
18 september 2026 -
C++26 Contracts
11 september 2026 -
Cargo – konvention framför konfiguration
4 september 2026 -
Referenser & pekare i Rust jämfört med C++
28 augusti 2026 -
När Rust får panik gör C++ ett undantag
21 augusti 2026 -
Rust syntax jämfört med C++
14 augusti 2026 -
Fem skäl att välja Rust över C++
10 augusti 2026 -
Apollo 11 och kvinnan bakom koden
12 april 2026